Trong SEO, thuật ngữ “crawler trap” (hay “spider trap”) dùng để chỉ một vấn đề về mặt cấu trúc bên trong một website làm cho các bọ quét tìm thấy một số lượng lớn hoặc vô tận các địa chỉ URL. Về mặt lý thuyết, các bọ quét có thể bị “mắc kẹt” tại khu vực đó và sẽ tiếp tục thu thập dữ liệu của những địa chỉ URL như thế mà không có điểm dừng.
Chẳng hạn, Google có thể quét qua một trang và tìm thấy 10 URL mới trên đó. Nếu nó quét qua 10 URL này, nó có thể sẽ phát hiện thêm 10x15 địa chỉ URL mới. Nếu bọ tiếp tục quét qua 150 URL này, thì số lượng URL mới lúc này có thể được nâng lên thành 150x20 = 3.000. Bạn có thể thấy số lượng này gia tăng cực kỳ nhanh chóng.
Nếu mỗi địa chỉ URL trong số này đều có nội dung độc quyền (unique) và đủ tốt thì điều này sẽ phải không là vấn đề, nhưng thực tế lại không được như thế. Do đó, tình trạng này sẽ gây ra vấn đề lớn có liên quan đến nội dung trùng lặp (duplicate content).
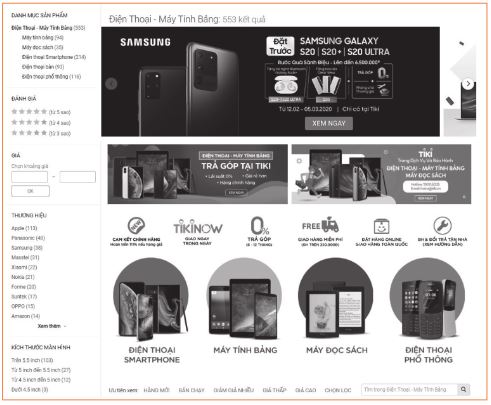
Một ví dụ cho loại “bẫy” crawler trap này chính là hệ thống điều hướng phức hợp (faceted navigation1) giống như trên các website bán hàng, thường tạo ra hàng trăm hoặc hàng ngàn tổ hợp giữa các thông số trong địa chỉ URL (URL parameter). Mỗi sự kết hợp mới giữa các tiêu chí nào đó (và theo đó là các thông số kèm theo) sẽ tạo nên một địa chỉ URL mới. Nên việc tổ chức cấu trúc điều hướng phức hợp kém hiệu quả thường là nguyên nhân phổ biến dẫn làm cho bọ quét rơi vào bẫy crawler trap.
1. Hệ thống điều hướng phức hợp (faceted navigation) là cách tổ chức luồng điều hướng phổ biến trên các website thương mại điện tử, cho phép người truy cập có thể lọc và sắp xếp các kết quả dựa trên những thuộc tính của sản phẩm, chẳng hạn như người dùng có thể lọc ra các sản phẩm theo danh mục, chủng loại, giá cả, thương hiệu, màu sắc, kích cỡ, đánh giá, tính năng…
Nếu người dùng lựa chọn các bộ lọc khác nhau để lọc kết quả thì URL sẽ có dạng như sau:

Một ví dụ khác chính là khi website có các trang theo ngày (date pages). Nếu người dùng có thể quay lùi lại một ngày để xem trang của ngày trước đó và liên tục lùi lại, lùi lại những ngày cũ hơn thì website có thể có một số lượng trang khổng lồ.
Một crawler trap sẽ không tốt cho hoạt động SEO vì mỗi khi Google thu thập dữ liệu một trang có trong “bẫy” của bạn, nó đang không thu thập những nội dung thực thụ trên website.
Các nội dung mới, có chất lượng cao và cực kỳ giá trị có thể được lập chỉ mục sau, hoặc thậm chí là không được lập chỉ mục vì Google đang dành nhiều nguồn lực của nó cho cái bẫy này. Và những nội dung mà nó đang quét qua sẽ được xem là trùng lặp và làm giảm đi giá trị tổng thể của website trong mắt Google.
Đây là lý do tại sao việc xử lý các crawler trap lại rất quan trọng cho SEO, nhất là khi bạn đang nghĩ đến việc tối ưu hóa crawl budget1.
1. Crawl budget là số lượng trang trên website mà máy tìm kiếm quét qua để thu thập dữ liệu và lập chỉ mục trong một khung thời gian nhất định. Về cơ bản, bạn có thể hiểu đây là mức độ chú ý của máy tìm kiếm dành cho website.
Các crawler trap sẽ chỉ làm cho bọ quét tập trung vào những trang không có giá trị về độ liên quan (relevance) hay phù hợp với hoạt động SEO. Điều này sẽ làm lãng phí đi crawl budget. Khi các bọ tập trung vào việc thu thập dữ liệu những trang không liên quan này, thì sự chú ý dành cho các trang quan trọng của bạn cũng bị bỏ qua.
Quay trở lại với vấn đề, khi bạn thực hiện kiểm sát (audit) cho website, bạn có thể gặp rất nhiều trường hợp bẫy crawler như trên. Cách dễ dàng nhất để xử lý tình trạng này, chính là chặn chúng bằng một lệnh disallow trong file robotstxt.
Hãy thêm những dòng lệnh sau vào file robotstxt:
User-agent: *
Disallow: /cgi-bin/
Disallow: /wp-admin/
Disallow: /xmlrpcphp
Disallow: /trackback/
Disallow: /feed/
Bạn có thể tùy ý áp dụng lệnh disallow này đối với các link trong bảng tin (feed link), các link trong bình luận (comment link), các link rút gọn (shortlink) cũng như các link wp-json (WordPress JSON).
Nhưng mọi vấn đề luôn có một số trường hợp ngoại lệ và trên một số website bạn vẫn có thể mong muốn hệ thống tìm kiếm thu thập dữ liệu của chúng.