Năm 2020, Google đã nâng cấp công nghệ trí tuệ nhân tạo (AI). Bộ máy tìm kiếm hiện nay rất hiệu quả trong việc đưa ra những nội dung phù hợp, đồng thời cũng hạn chế và “kìm hãm” các nội dung spam, thao túng SEO hoặc tối ưu hóa quá liều (over optimization).
Để được xếp hạng cao hơn, bạn cần phải có hướng đi đúng đắn khác biệt – bằng cách cộng hưởng với yếu tố “vector”, với mẫu hình (pattern) mà hệ thống đang phân loại và mẫu hình của những nội dung đang được nhiều người dùng nhấp vào (đáp ứng mong đợi của họ).
Ở đây có hai cơ chế là “phân loại” và “nhấp vào”. Đây là hai hệ thống tách biệt với nhau – một là Bộ máy Ngữ nghĩa (Semantic Engine) với vai trò phân loại, chấm điểm, xếp hạng cho nội dung và một là Bộ máy Đánh giá chất lượng (Quality Engine) với vai trò xác minh cho các lượt click vào những nội dung đó, đồng thời xác minh cho Bộ máy Ngữ nghĩa. Nếu không đáp ứng được cả hai bộ máy này, bạn sẽ không thể có thứ hạng cao.
☑ Bộ máy ngữ nghĩa có xu hướng vận hành dựa trên một hệ thống bao gồm hai cơ chế lập chỉ mục (index) hay hai cơ chế phân loại (sort).
☑ Quy trình:
+ Hệ thống tìm thấy các trang (page) và đánh dấu lại để thu thập dữ liệu (crawling).
+ Trang của bạn có thể được tìm thấy nhưng không được thu thập dữ liệu, ví dụ như nếu hệ thống phân loại nó là trang spam.
+ Hệ thống thu thập dữ liệu các trang và đánh dấu lại để lập chỉ mục.
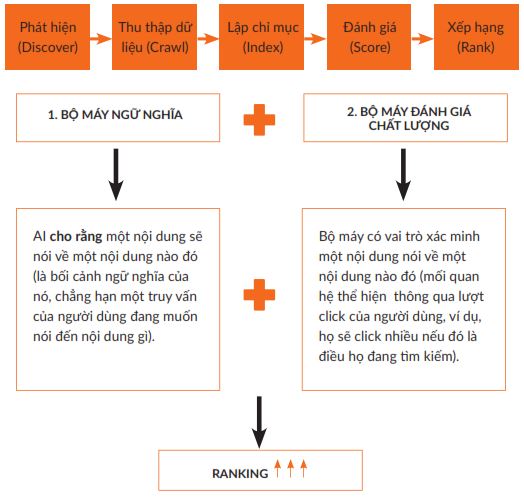
Trang của bạn có thể được tìm thấy, thu thập dữ liệu nhưng không được lập chỉ mục vì một vấn đề nào đó, chẳng hạn như nội dung trùng lặp (duplicate content). Lúc này, trang vẫn tồn tại trong danh mục chỉ mục phụ (supplemental index) nhưng không nằm trong danh mục chỉ mục chính (main index).
Để có thể xử lý số lượng trang khổng lồ trên Internet, Google lưu trữ các trang vào hai cơ sở dữ liệu. Một là danh mục chỉ mục chính, còn lại là danh mục chỉ mục phụ. Chỉ có danh mục chỉ mục chính được sử dụng để lựa chọn các kết quả trả về cho mỗi truy vấn tìm kiếm. Còn danh mục chỉ mục phụ sẽ lưu trữ tất cả các trang còn lại bao gồm những trang có nội dung trùng lặp hoặc không tương tích/ phù hợp với tìm kiếm của người dùng.
Hệ thống lập chỉ mục các trang và đánh dấu lại để xếp hạng một trang nhanh hoặc chậm (dựa trên chất lượngmức độ tin cậy hiện tại của trang web từ bộ máy chất lượng và thậm chí là mức độ tin cậy của trang, chủ đề của trang đó từ Bộ máy Ngữ nghĩa).
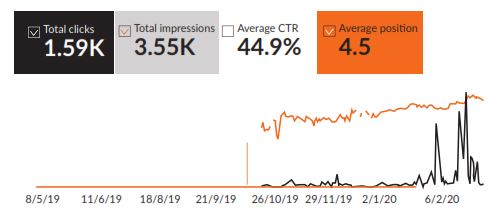
Sandbox1 tồn tại và được xếp hạng nhanh hay chậm sẽ phụ thuộc vào mức độ tin cậy hiện tại mà hệ thống dành cho trang web, dựa trên điểm số chất lượng (quality score), cũng như mức độ tiệm cận giữa nội dung của trang so với giả định của Bộ máy Ngữ nghĩa. Ngoài ra, đây cũng là một dấu hiệu cho thấy trang của bạn có được tin cậy nhiều hay không, thể hiện qua việc nó có được xếp hạng nhanh chóng hay không.
1. Sandbox xảy ra khi bạn thực hiện SEO cho một site mới hay từ khóa mới để hạn chế spam và thao túng. Google sẽ “kìm hãm” không cho trang của bạn xuất hiện trên SERP cho tới khi đủ tin cậy.
Trong Google Search Console, nếu đồ thị biểu diễn kết quả về thứ hạng (đường màu cam) của trang có những chấm và khoảng ngắt như hình trên thì đó là dấu hiệu cho thấy trang đang có vấn đề về độ tin cậy hoặc chất lượng. Bạn cần phải cải thiện tỷ lệ nhấp (CTR), tối hóa ưu tỷ lệ chuyển đổi (CRO) và có thể là cả nội dung của trang.
Đối với một trang web mới, chắc chắn là nó sẽ không nhận được nhiều sự tin tưởng từ Google, nhưng bạn hoàn toàn có thể làm cho trang web của mình thăng hạng nhanh chóng nhất với ít tài nguyên nhất nếu thực hiện đúng đắn các công việc cần thiết và theo một trình tự chính xác.
Thuật toán chính của Google hiện nay không còn tập trung nhiều vào yếu tố “LINK” nữa, thay vào đó, những yếu tố có sự tác động mạnh mẽ sẽ là “TRAFFIC” và “ONPAGE” (cụ thể là NLP và Vector).
CƠ CHẾ ĐÁNH GIÁ (SCORE) VÀ XẾP HẠNG (RANK) DIỄN RA NHƯ THẾ NÀO?
Như đã đề cập ở trên: “Bộ máy Ngữ nghĩa có xu hướng vận hành dựa trên một hệ thống bao gồm hai cơ chế lập chỉ mục hay hai cơ chế phân loại.”
1. Cơ chế phân loại đầu tiên (sort 1)
Mọi truy vấn tìm kiếm gửi đến Google đều được trả về khoảng 200 trang kết quả đầu tiên (tương ứng với 10 trang SERP) đã được xác định hay phân loại dựa trên cơ sở đánh giá – bởi bộ xử lý ngôn ngữ tự nhiên NLP; và thứ hạng sẽ được tổng hợp bởi mức độ trùng khớp với Vector, cùng với tất cả các thuật toán khác đã được áp dụng từ trước đến nay, bao gồm các thuật toán về liên kết (link), đánh giá chất lượng (quality), các thuật toán bộ lọc để “lọc” ra các kết quả phù hợp (filter), các hình phạt (penalty).
Vai trò của NLP và Vector rất quan trọng trong cơ chế này.
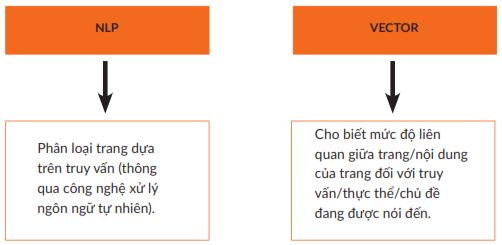
“Thực thể” ở đây là các đối tượng, sự vật, khái niệm mà một trang trình bày. Công nghệ NLP cùng với trí tuệ nhân tạo AI sẽ đánh giá xem một trang đang nói về chủ đề nào nhiều nhất và phân loại nó.
Tiếp theo, Vector sẽ phản ánh mức độ thể hiện của trang đó với thực thể đang được nói đến, mức độ tiệm cận (độ trùng khớp) của trang này so với các trang khác cũng đang nói về chủ đề đó.
2. Cơ chế phân loại thứ hai (sort 2)
Sau đó, các trang ở trên sẽ được phân loại một lần nữa và sắp xếp lại thứ hạng trước khi trả về kết quả cuối cùng cho người dùng. Cơ chế phân loại thứ hai này sẽ dựa trên:
1. Các thuật toán “QDDQDF” để các truy vấn có được kết quả tìm kiếm đa dạng (QDD) và mới nhất (QDF).
QDD = Query Deserves Diversity: Một trong những thuật toán xếp hạng của Google, đề cao yếu tố “đa dạng” (diversity). Thuật toán này cố gắng đáp ứng được ý định của người dùng bằng cách hiển thị các kết quả đa dạng với mức độ đối sánh rộng hơn (broader match). Google theo dõi hành vi của người dùng và nhận diện các mẫu hình tìm kiếm (search pattern) khi người dùng không tìm được các kết quả phù hợp, chẳng hạn như người dùng từ bỏ không tìm kiếm nữa, thử một truy vấn khác mà không nhấp vào kết quả nào hoặc liên tục rời đi (bounce) từ trang này đến trang khác.
QDF = Query Deserves Freshness: Một trong những thuật toán xếp hạng của Google, đề cao yếu tố “độ tươi mới” (freshness). Thuật toán này tập trung vào việc phân phối những nội dung mới nhất đối với một số truy vấn nhất định, bao gồm những xu hướng và tin tức mới nhất, những chủ đề “nóng” hay những sự kiện diễn ra lặp lại và được xác định dựa trên số lượng tìm kiếm tăng đột biến.
2. Ngoài ra, một số thuật toán khác cũng ảnh hưởng đến bước này bao gồm: thuật toán về vị trí địa lý (geolocation), thuật toán cá nhân hóa (personalization), các thuật toán ảnh hưởng đến Local Map Pack cùng những thuật toán mới có liên quan đến Bộ máy Đánh giá chất lượng như traffic, CTR, CRO...
Ở những nội dung đầu tiên này, chúng ta sẽ tìm hiểu về cách tối ưu hóa cho các trang để đáp ứng Bộ máy Ngữ nghĩa.
Hãy nhớ rằng Google đánh giá và xếp hạng cho các trang, không phải cho site. Vì vậy, một site với chỉ một page cũng có thể được xếp hạng cao!
Tuy nhiên tồn tại các đơn vị phân loại ở cấp độ site (site-based classifier). Một “classifier” là một bộ xử lý áp dụng công nghệ AI để thực hiện các phân tích về nội dung và “phân loại” cho nội dung đó. Phần lớn các đơn vị phân loại hiện nay đều được xây dựng trên nền tảng xử lý ngôn ngữ tự nhiên (NLP). Ngoài ra, các “classifier” cũ trước đây có thể vẫn còn hoạt động (cơ chế của chúng khá đơn giản, chẳng hạn như trang có “.com” sẽ được xếp hạng tốt hơn).
Các đơn vị phân loại ở cấp độ site sẽ xác định một site nói về một chủ đề nào đó, có đáng tin cậycó chất lượng hay không (dựa trên mẫu hình về lượt click – click pattern, phản ánh mức độ thỏa mãn ý định của người dùng), mức độ liên quan về mặt địa lý đối với một khu vực (geographic relevance) để xếp hạng trên Map Pack, hay có thể kích hoạt các tính năng đặc biệt trên SERP (chẳng hạn như trích dẫn nổi bật – featured snippet) hoặc không.
Có khoảng 20 đơn vị phân loại ở cấp độ trang web như thế. Ngoài ra còn có các đơn vị phân loại cho cụm trang (page cluster classifier) như rel= “next”/“prev”1, các SILO...
1. rel= “next” và rel= “prev” là các thuộc tính của một liên kết (link attributes) chỉ ra mối quan hệ giữa một chuỗi các trang với nhau cho máy tìm kiếm.
Nhưng chúng ta không cần quan tâm đến các yếu tố phân loại này vì nhiệm vụ của chúng chỉ là “phân loại”. Các “classifier” này đóng vai trò như những bộ lọc và kết hợp cùng với các YẾU TỐ XẾP HẠNG ở cấp độ trang để quyết định thứ hạng cho trang (không phải site).
Do vậy, việc cần làm đó là xây dựng trang một cách tối ưu, giữ cho mọi thứ được mạch lạc và đơn giản để Google có thể dễ dàng xác định xem trang của bạn nói về vấn đề gì, với mức độ cụ thể ra sao. Thậm chí trang vẫn có thể được xếp hạng tốt mà không có bất kỳ liên kết nào (link) hoặc nằm trên một trang web nói về một chủ đề khác.
XÂY DỰNG VECTOR (TỐI ƯU ON-PAGE CHO HAI CƠ CHẾ PHÂN LOẠI)
Hoạt động SEO On-page đã có sự thay đổi lớn, không còn xoay quanh EMQ (Exact Match Query – truy vấn trùng khớp chính xác) hay PMQ (Partial Match Query – truy vấn trùng khớp một phần) nữa.
Nói cách khác, “từ khóa” hiện nay không còn quan trọng, hoặc ít nhất là không còn nắm giữ nhiều trọng số như trước đây.
1. Google đang sử dụng một bộ máy xử lý ngữ nghĩa mới
• Áp dụng công nghệ xử lý ngôn ngữ tự nhiên NLP để phân tích, xử lý về ngữ pháp, bối cảnh ngữ nghĩa của trang, từ đó đánh giánhận diệnphân loại các đối tượng thực thể trên trang, chủ ngữ, vị ngữ của câu và theo đó là xác định xem trang đang nói về chủ đề gì.
NLP này có sự tương đồng với công cụ NLP API mà Google cung cấp nhưng chúng không hoàn toàn giống nhau và có thể cũng không chia sẻ chung một cơ sở dữ liệu (database).
• Áp dụng cơ chế phân tích Vector, đối sánh với các tổ hợp từ ngữ tiêu biểu (collocation) hay cách diễn đạt mà những trang khác trên Internet đang sử dụng để nói về một chủ đề cụ thể để so sánh xem trang của bạn thể hiện về chủ đề đó (hay “trùng khớp”) ở mức độ nào.
Nếu bạn có thể trình bày nội dung về một chủ đề theo một cách đúng đắn và áp dụng đúng cách thức diễn đạt (cụ thể là các từ và cụm từ) mà những trang khác áp dụng cho chủ đề đó, các máy tìm kiếm có thể dễ dàng hiểu được bạn đang muốn nói đến điều gì, từ đó giúp nâng cao thứ hạng.
Hai thuật toán về NLP và Vector này sẽ được kết hợp cùng với nhau để đưa ra mức đánh giá, làm cơ sở cho việc quyết định xếp hạng của trang.
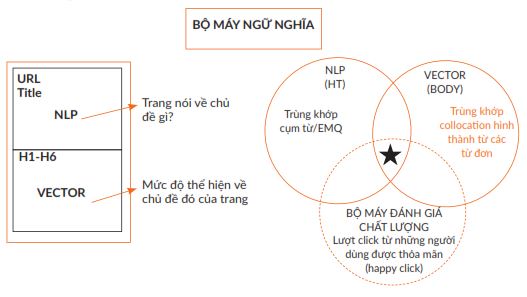
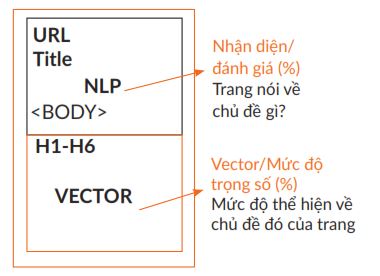
Quá trình xử lý ngôn ngữ tự nhiên NLP bắt đầu từ các thành phần ở đầu trang như địa chỉ URL, tiêu đề Title và xuống đến phần nội dung <body> với các thẻ H1-H6 hoặc những câu chủ đề (topic sentence) để đánh giá cũng như xác định khả năng (%) mà một trang nói về chủ đề X nào đó.
Và Vector sẽ được áp dụng để đối sánh với các cụm collocation được hình thành từ các từ đơn (single word) trùng khớp trong nội dung, chủ yếu từ phần thân (body) trở xuống (ngoài ra, Vector còn có thể được đặt vào một thành phần có tên gọi là “aspect” trong Title.) Vector sẽ xác định xem nội dung của bạn thể hiện bao nhiêu (%) về chủ đề X, hay mức độ mà nội dung của trang “tiệm cận” với chủ đề đó.
Trang của bạn có thể được tối ưu cho NLP nhưng không tốt cho Vector. Bộ máy tìm kiếm có thể biết rõ rằng trang của bạn nói về một chủ đề X nào đó (thể hiện qua URL, Title, thẻ H1...). Bạn có thể đạt được mức 99% cho biết rằng trang nói về chủ đề gì, hay chính xác hơn là thực thể của trang nói về chủ đề gì. Nhưng nếu ở phần nội dung trong trang lại nói về một chủ đề khác (làm “chệch hướng” Vector sang một chủ đề khác) thì mức độ thể hiện (%) về chủ đề X của trang sẽ không được đánh giá cao.
Ngoài NLP và Vector, Bộ máy Đánh giá chất lượng cũng sẽ kết hợp cùng hai thuật toán trên để giúp hoàn thiện toàn bộ quy trình này, thể hiện qua những lượt click khi trang được người dùng nhấp vào (là những lượt click khi người dùng cảm thấy trang có thể đáp ứng được truy vấn tìm kiếm của họ).
Và điểm giao trong hình phía trên (biểu tượng ngôi sao) sẽ là vị trí mà trang của bạn cần hướng đến. Bạn muốn trang của mình đáp ứng NLP một cách tối ưu, xây dựng được Vector hướng về chủ đề một cách tốt nhất và nhận được số lượng click nhiều nhất có thể.
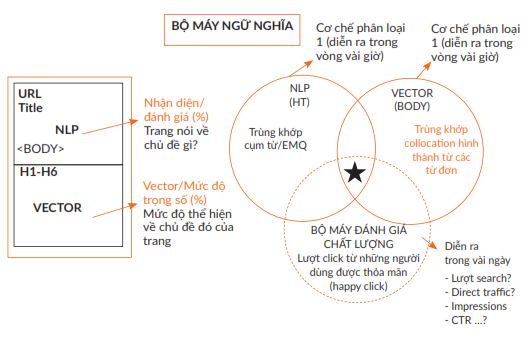
Quá trình xử lý NLP sẽ được áp dụng trong cơ chế phân loại 1 đã được trình bày ở nội dung trước. Và Vector sẽ được áp dụng trong cả cơ chế phân loại 1 và 2. Sau khi chỉ mục, hệ thống có thể tiến hành phân loại trang trong vòng vài giờ.
Và sau đó, Bộ máy Đánh giá chất lượng sẽ mất vài ngày để xử lý, tùy thuộc vào số lượt click mà bạn nhận được, những tìm kiếm đó là gì, lượng truy cập trực tiếp là bao nhiêu, lượt hiển thị là bao nhiêu, tăng giảm thế nào, tỷ lệ CTR của các lượt click ra sao...
Tóm lại, NLP thường sẽ nhìn vào những vị trí quan trọng đối với một trang, bao gồm:
• Địa chỉ URL
• Tiêu đề
• Các thẻ H (H1-H6)
• Câu chủ đề (topic sentence, giới thiệu chủ đề được trình bày trong một đoạn văn nào đó)
Một điều nữa cần lưu ý, đó là: phải nhất quán giữa các tín hiệu. Chẳng hạn như địa chỉ URL thể hiện bạn đang nói đến “X” nhưng trong thẻ H2 lại nói đến “Y”, lúc này hệ thống sẽ không xử lý hiệu quả vì có hai thực thể khác nhau.
Do đó bạn cần phải có sự đồng nhất tại tất cả những vị trí quan trọng hỗ trợ cho NLP xử lý và hiểu được trang của bạn đang muốn nói đến điều gì; và Vector sẽ cho biết rằng trang của bạn có liên quan cũng như thể hiện về nội dung đó ở mức độ nào.
Hãy nhớ rằng:
Google muốn xây dựng một hệ thống đối ứng 1:1 – mỗi câu hỏi/ truy vấn của người dung sẽ tương ứng với một câu trả lời hoàn hảo (là page topic hay chủ đề của trang).
Để xếp hạng, hãy xây dựng và phản ánh các vector trong nội dung của mình để truyền đi tín hiệu cho máy tìm kiếm biết được chúng ta đang muốn đề cập đến điều gì trên trang.
Khi người dùng nhập vào truy vấn tìm kiếm về X, Google muốn biết được trang nào nói về X, nói về X ở mức độ nào và đáp ứngthỏa mãn nhu cầu tìm kiếm của người dùng về chủ đề X tốt ra sao.
Sau cùng thì, Bộ máy Đánh giá chất lượng sẽ là bộ máy “chủ lực” vì nó có vai trò xác minh cho những kết quả của Bộ máy Ngữ nghĩa.
2. Hiểu thêm về NLP & Vector
Có một điểm quan trọng cần lưu ý: NLP hoạt động dựa trên cụm từ (phrase-based) trong khi Vector hoạt động dựa trên các từ đơn (single-word-based).
Để hiểu rõ hơn về điều này, chúng ta sẽ cùng phân tích một ví dụ.
Giả sử chúng ta có một từ khóa là “best mattress topper”.
NLP sẽ nhìn vào tiêu đề trên trang, cụ thể hơn là cả câu trong tiêu đề đó, chẳng hạn như:
“Best mattress topper: Sale on now”
NLP sẽ đọc qua toàn bộ câu và tất cả các cụm từ có trong câu đó. Và nó sẽ tiến hành nhận diện đối tượng thực thể bằng công nghệ xử lý ngôn ngữ tự nhiên. Quá trình xử lý này có thể được mô phỏng lại bằng cách thao tác với công cụ Natural Language API của Google. Bạn có thể truy cập tại địa chỉ: https://cloudgooglecomnatural-language
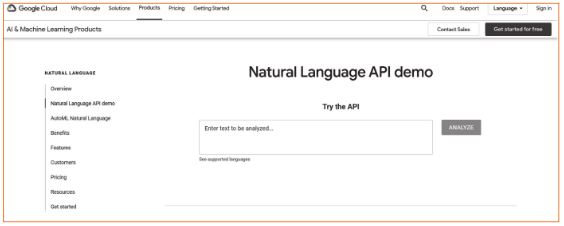
Nhập tiêu đề mà chúng ta cần phân tích rồi nhấp vào nút “Analyze”. Dưới đây là kết quả trả về tương ứng.
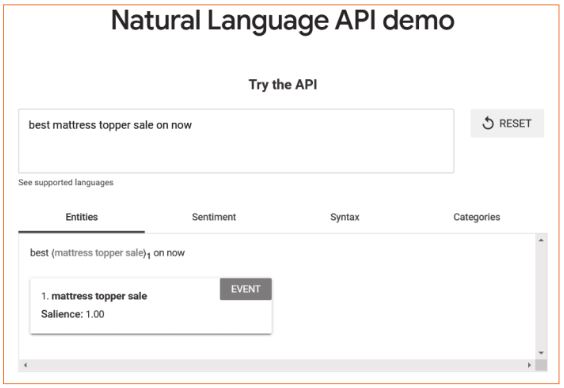
Công cụ này phân tích được có một sự kiện (event) đang được đề cập đến trong câu ở trên, đó là dịp khuyến mãi đối với sản phẩm tấm topper nệm. Và điều quan trọng là ở đây, trái ngược với những gì chúng ta thường nghĩ, không có một thực thể nào tên là “best mattress topper” được nhận diện qua xử lý ngôn ngữ tự nhiên.
Tuy nhiên, vì đây là một công nghệ mới nên sẽ cần thời gian để hoàn thiện thêm, nhưng quan trọng là công cụ NLP API không phải là bộ máy NLP thực sự đang được Google áp dụng, chúng ta chỉ sử dụng ví dụ này để hình dung về cách thức hoạt động của quá trình xử lý ngôn ngữ tự nhiên.
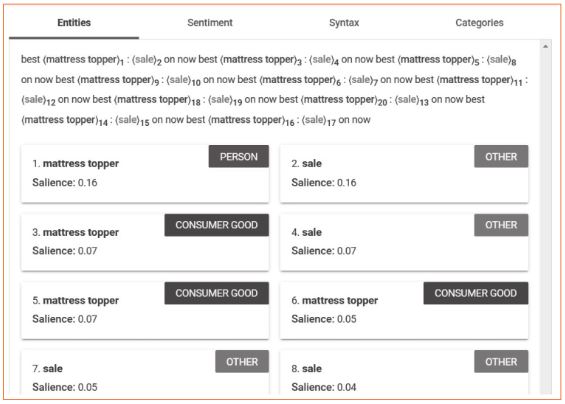
Bạn có thể thấy nếu chúng ta thực hiện một thay đổi nhỏ trong câu được phân tích, chẳng hạn như hình dưới đây là thêm vào dấu “:” để giống hoàn toàn với tiêu đề gốc thì kết quả nhận được khá bất ngờ.
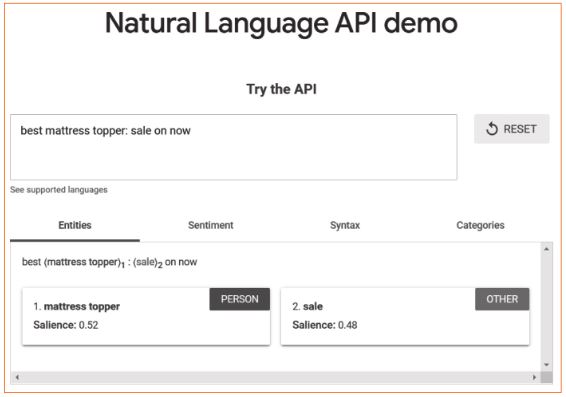
Lúc này, NLP nhận diện được hai thực thể là “mattress topper” và “sale” với điểm số “Salience” là 0.52 (52%) và 0.48 (48%). Đây là mức điểm thể hiện tầm quan trọng, sự nổi bật hay mức độ trọng tâm của một thực thể trong đoạn văn bản được phân tích. Tuy nhiên thực thể “mattress topper” lại được phân loại là “person”. Do vậy bạn phải thật cẩn thận khi đặt tên trang của mình vì chỉ cần một sự thay đổi nhỏ cũng có thể khiến hệ thống xếp hạng cho một trang khác.
Tuy không hoàn toàn giống nhau về bản chất và có độ chính xác cao nhưng ví dụ về công cụ ở trên có thể giúp chúng ta hiểu rõ hơn về cách Google xử lý và nhận diện đối tượng bằng NLP.
Ngoài ra, nếu bạn cung cấp một đoạn văn bản đủ dài, công cụ này cũng có thể đưa ra phân tích về loại danh mục mà nội dung đó đang thể hiện.
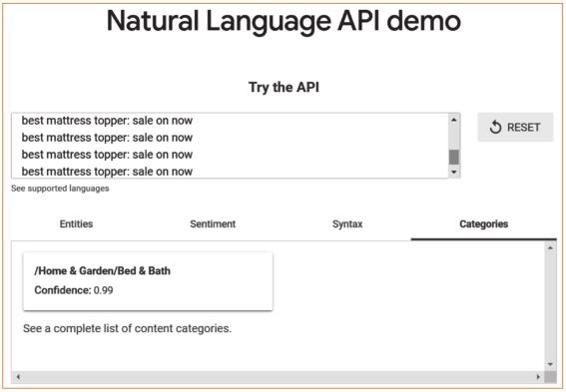
Ở đây chúng ta có kết quả danh mục là “Home & GardenBed & Bath”, với điểm “Confidence” là 0.99. Nghĩa là bộ máy chắc chắn 99% nội dung được phân tích có liên quan đến danh mục này. Và đây cũng là một cơ sở để xác định xem trang của bạn nói về chủ đề gì, khi nhìn vào những vị trí quan trọng như địa chỉ URL, Title, H1-H6, các câu chủ đề (topic sentence) của những đoạn văn, các tiêu đề nằm ở trên cùng của mỗi khu vực nội dung (block of text)...
Tuy nhiên, danh mục được xác định này không phải là cơ sở để xếp hạng, mà chỉ là yếu tố hỗ trợ cho chủ đề mà trang đang thực sự nói đến trong nội dung – đây mới là yếu tố giúp cho trang được xếp hạng. Nhiều người thường hay cố gắng tăng điểm “confidence score” lên càng cao càng tốt vì họ nghĩ rằng điều đó sẽ giúp họ được xếp hạng cao hơn. Nhưng điều đó không đúng vì:
Hệ thống không xếp hạng trang dựa trên danh mục; mà phân loại trang dựa trên thực thể lớn nhất (có điểm số “salience score” nổi bật nhất) được nhận diện trong nội dung được phân tích.
Và việc xếp hạng sẽ dựa trên mức độ “Vector hóa” của nội dung, hay nội dung có phản ánh được vector đối với thực thể đó hay không.
Nghĩa là nội dung của trang có xây dựng và đặt đầy đủ vector để bộ máy có thể nhận diện, liên kết và tổng hợp lại để biết được trang đang hướng đến chủ đề hay thực thể nào.
Có thể hiểu một cách đơn giản: Vector là một khái niệm trừu tượng, thể hiện những gì cần thiết để “mang” một điểm đến một điểm khác. Giả sử trong nội dung của chúng ta có chứa các “manh mối” về một chủ đề X nào đó, nếu bộ máy có thể liên kết và tổng hợp các “manh mối” này lại thành một vector, nó có thể hiểu được nội dung đó đang “hướng về” chủ đề X (hãy hình dung các “manh mối” này đóng vai trò như là các yếu tố định hướng, tạo nên chiều trong không gian ngữ nghĩa dẫn bộ máy xử lý đi từ “nội dung” đến “chủ đề” thực sự mà nó đang muốn thể hiện).
Như vậy, điểm số “Confidence” và danh mục được xác định ở trên không tác động đến việc xếp hạng, mà chỉ giúp hỗ trợ cho việc phân loại thực thể với điểm số “Salience” nổi bật trong nội dung được phân tích. Và đối tượng được xếp hạng ở đây không phải là “danh mục”, mà là “thực thể” được nhận diện.
Đây cũng là một điều hợp lý vì tính cụ thể (specificity) sẽ đóng vai trò quan trọng. Chính sự phân loại cụ thể ở cấp độ “thực thể” mới là yếu tố hỗ trợ và đáp ứng cho truy vấn của người dùng, không phải là một danh mục được phân loại ở mức độ tổng quát (general categorization).
Hãy nhớ, công cụ này chỉ được xem là mô phỏng cho công nghệ AI cùng với cơ chế xử lý ngôn ngữ tự nhiên NLP mà Google thực sự đang áp dụng.
Ở đây chúng ta chỉ phân tích dựa trên một đoạn nội dung được nhập vào trực tiếp; không phải một web page. Một web page sẽ có địa chỉ URL, có Title... chứa các dữ liệu metadata mô tả về các đối tượng trên trang, bộ máy sẽ sử dụng những cơ sở này để phân loại “thực thể” và những gì mà nội dung trang đang trình bày, trước khi xem xét thêm những dữ kiện khác.
Ngoài ra, Google rất hạn chế trong việc cung cấp những công cụ chính thức hỗ trợ cho giới SEO vì nguy cơ nhiều người sẽ lạm dụng nó để thao túng kết quả tìm kiếm (SERP). Đây là một vấn đề mà họ luôn muốn ngăn chặn và đồng thời nó cũng là một mâu thuẫn, bởi nếu có những công giúp cho việc làm SEO hiệu quả hơn thì chất lượng trang cũng sẽ được nâng cao và trải nghiệm người dùng cũng sẽ ngày càng được cải thiện – đó cũng là điều mà Google luôn muốn hướng đến.
Tuy nhiên, ở thời điểm hiện tại, đây vẫn chỉ là một công cụ mô phỏng giúp chúng ta hiểu được cách thức bộ máy NLP sẽ xử lý và phân loại các đối tượng bằng cách nhìn vào những vị trí quan trọng nhất trên một trang và đưa ra một mức đánh giá xem trang có khả năng nói về chủ đề gì.
Song song đó, cơ chế phân tích Vector cũng được thực hiện để phản ánh mức độ thể hiện của trang về chủ đề đó là bao nhiêu.
Hai mức đánh giá này sẽ được kết hợp với nhau (gần đây, vai trò của Vector thể hiện nhiều sức mạnh hơn) làm cơ sở cho việc quyết định thứ hạng.
Ngoài ra, công cụ NLP API của Google còn cung cấp thêm chức năng phân tích cả cú pháp ngữ pháp (grammar syntax) của nội dung tại tab “Syntax”.
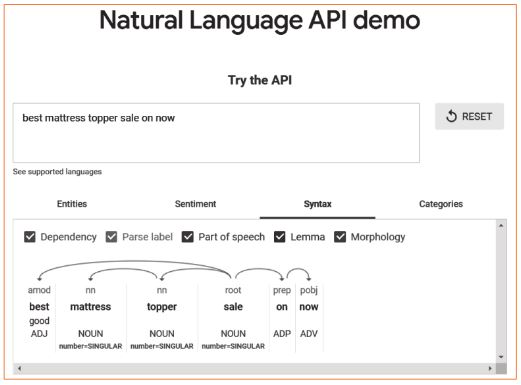
Các thực thể sẽ được nhận diện và phân loại dựa trên kết quả phân tích cú pháp của câu. Và đây cũng chính là cách mà Vector hoạt động. Vector được hình thành từ những từ thường đứng gần nhau hoặc xuất hiện cùng nhau.
Hãy nhớ là NLP hoạt động dựa trên nền tảng là cụm từ còn Vector sẽ dựa trên các đơn vị từ. Bởi nếu đổi Vector hoạt động trên cơ chế ghép cụm từ thì sẽ có vô số tổ hợp và biến thể được tạo thành và có thể vượt quá khả năng xử lý của bộ máy.
Giả sử chúng ta có hai tài liệu chứa các từ ngữ. Làm thế nào để một bộ máy không có khả năng phân tích và tư duy như con người có thể biết chúng nói về cùng một chủ đề?
Nếu cả hai đều đề cập đến cùng một từ nào đó nhiều lần thì có thể chúng đang nói về cùng một chủ đề. Đó là cách làm trước đây của Google, nhưng từ lâu Google đã thực hiện một số thay đổi để cơ chế xử lý trở nên tinh vi hơn.
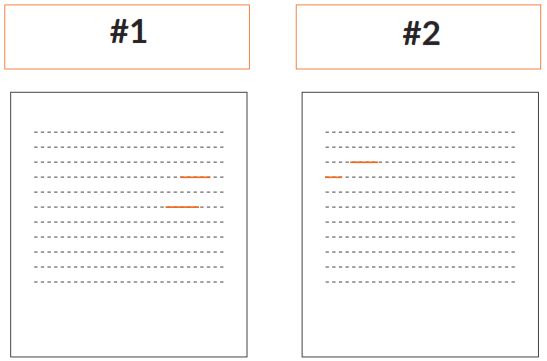
Chúng ta có những từ màu đỏ là những từ quan trọng (những từ nằm trong truy vấn của người dùng). Sử dụng lại ví dụ về “best mattress topper” ở phía trên, NLP sẽ hoạt động theo cơ chế đối sánh với cụm từ “best mattress topper”, còn Vector sẽ tìm kiếm theo các đơn vị từ ngữ “best”, “mattress” và “topper”.
Bộ máy xử lý sẽ nhìn vào các từ xuất hiện bên cạnh “node”1 (gọi là collocate). Đây là những từ được đặt ở bên trái hoặc phải, trước hoặc sau các từ nằm trong truy vấn mà người dùng đang tìm kiếm (“best”, “mattress”, “topper”) có mức độ quan trọng giảm dần theo khoảng cách và càng được kết hợp với nhau thành một cụm từ tiêu biểu (collocation), càng ở gần “node” thì những từ này sẽ càng tạo ra nhiều sức mạnh hơn.
1. Theo thuật ngữ của công nghệ xử lý ngôn ngữ, “node” là từ trung tâm trong một collocation (sự kết hợp tiêu biểu của những từ đơn với nhau hay những từ thường đi cùng với nhau). Ví dụ như: “strong wind” = “strong” (là collocate) + “wind” (là node).
Bạn có thể sẽ thấy cơ chế này giống với LSI hay TF-IDF. Nhưng về bản chất thì chúng lại hoàn toàn khác biệt. LSI có thể được đặt ở bất kỳ đâu trong nội dung của trang. Còn TF-IDF (Term Frequency – Inverse Document Frequency) sẽ đánh giá tầm quan trọng một từ/ cụm từ, thông qua số lần xuất hiện của nó trong tài liệu so với tần suất của từcụm đó trong toàn bộ tập dữ liệu.
Chính xác thì Vector có liên quan đến “collocation”.
Vector tập trung vào những từ quan trọng (node) được kết hợp với những từ khác (collocate) để tạo thành một cụm từ đặc trưng (collocation) và những từ ngữ này có thể được đề cập đến tại bất kỳ đâu trong toàn bộ corpus2 trên Internet hoặc tất cả các trang mà Google đã tìm thấy và quét qua.
2. Corpus là một dữ liệu tập hợp các văn bản, ngôn ngữ đã được số hóa.
Ví dụ, đối với một từ quan trọng trong tài liệu #1 dưới đây, bộ xử lý có thể so sánh và đánh giá mức độ tương đồng của nó so với một tài liệu #2 khác bởi vì tài liệu #1 có sự trùng khớp và thể hiện cùng một mẫu hình đặc trưng (typical pattern) trong nội dung; cụ thể là tại bất kỳ nơi nào mà từ quan trọng đó được đề cập thì xung quanh nó luôn có những từ kết hợp tương ứng đi kèm (collocate) như trong tài liệu #2 và những từ này trở nên rất mạnh mẽ trong việc thúc đẩy sự tồn tại của từ trung tâm, cho bộ máy xử lý biết được trang của bạn nói về từ quan trọng đó.
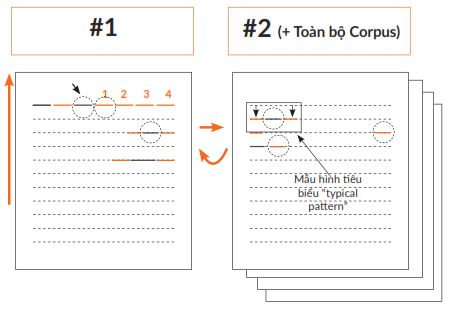
Các mẫu hình đặc trưng này sẽ giúp xác minh cho tài liệu đang được đối sánh. Tài liệu đó có thể nói về những khái niệm và sự vật khác nhau có liên quan đến chủ đề chính nhưng khi đề cập đến từ quan trọng thì ở một mức độ nhất định (%), nó luôn có những từ kết hợp đi kèm mà những tài liệu khác trong toàn bộ corpus cũng đề cập đến (đây chính là mẫu hình cụm từ đặc trưng được áp dụng thể hiện mối quan hệ giữa “node” và “collocate” trong việc hình thành nên “collocation” được sử dụng phổ biến khi nói về một chủ đề nào đó).
Vector sẽ hoạt động dựa trên cơ chế như thế. Ngoài ra, cũng có một công cụ hỗ trợ giúp phân tích các địa chỉ URL và cho chúng ta biết chính xác những từ ngữ nào sẽ phối hợp với nhau để tạo thành collocation.
Tóm lại, NLP sẽ hoạt động theo cơ chế giống với những gì chúng ta đã được quan sát qua công cụ Natural Language API của Google. Nó sẽ nhìn vào địa chỉ URL, Title và những vị trí định danh quan trọng trên trang để xác định xem trang nói về điều gì, đối tượng thực thể mà trang đang thể hiện, mức độ nổi bật và quan trọng của thực thể đó đối với trang này ra sao.
Còn Vector sẽ hoạt động và đánh giá dựa trên mức độ trùng khớp với các collocation có trong nguồn corpus (các cụm từ này được trang sử dụng ở mức độ nào). Bởi vì trong nội dung, chúng ta đang trình bày các từ ngữ được kết hợp cùng với nhau (collocated words) tại những vị trí thường được kết hợp cùng với nhau (collocated places).
Nghĩa là: bạn sẽ trình bày từ ngữ theo sự kết hợp đặc trưng và phổ biến nhất (collocated words) và đặt các collocation này vào những vị trí quan trọng, thường đi chung với nhau và được liên kết với nhau nhiều nhất (collocated places) để tạo nên sức mạnh và bối cảnh ngữ nghĩa rõ ràng cho bộ máy xử lý.
Bạn càng biết nhiều về các collocation và mức độ đặc trưng hay phổ biến của chúng trong tệp dữ liệu corpus, bạn sẽ càng biết cách tạo ra tỷ trọng Vector cao hơn và làm cho trang của mình thể hiện thật cụ thể, rõ ràng về bất cứ chủ đề nào mà NLP đã phân loại cho trang trước đó.
Đây chính là lý thuyết về Bộ máy Ngữ nghĩa và cơ chế vận hành của nó.
TÓM TẮT
☑ Các nghiên cứu và thử nghiệm vào tháng 1 năm 2020 đã cho thấy Google đang ứng dụng một mô hình xử lý ngôn ngữ tự nhiên NLP để xác định xem nội dung của một web page nói về chủ đề gì.
☑ Các nghiên cứu cũng cho thấy cơ chế này được áp đụng để cải thiện hiệu quả của việc nhận diện và phân loại, không phải cho việc xếp hạng.
☑ Bộ máy xử lý sẽ chọn ra các “thực thể” bằng cách phân tích cấu trúc ngữ pháp của câu và cụm từ/ hoặc về cơ bản, là chọn ra các “sự vật” và xác định những cụm từ nào cho biết rằng trang đó nói về điều gì.
Có sự kết hợp của các thuật toán với nhau.
NLP hoạt động từ đầu trang trở xuống, nhìn vào các cụm từ và cách diễn đạt.
Sau đó bộ máy xử lý sẽ sử dụng khoảng cách gần nhau của Vector (Vector proximity) để đánh giá xem tài liệu này trùng khớp (match) với chuẩn đối sánh cho chủ đề đó ở mức độ nào.
Vector hoạt động chủ yếu từ phần <body> của nội dung trở xuống, nhìn vào khoảng cách gần nhau của các từ đơn (single word).
☑ Chúng ta sẽ sử dụng công cụ phân tích collocation để tìm cách làm cho nội dung “khớp” với các vector này, từ đó tăng được mức độ thấu hiểu của bộ máy xử lý đối với trang và nâng cao thứ hạng.