Trong các danh sách tài sản ở Chương 15, tôi đã chỉ ra tính lôgic của một phân phối phân dạng: nếu tài sản tăng gấp đôi từ 1 triệu lên 2 triệu, khả năng số người có số tiền đó sẽ được chia làm bốn, tức 22. Nếu số mũ là 1, khi đó, khả năng tài sản đó sẽ được chia đôi. Số mũ đó được gọi là “lũy thừa” (đó là lý do mọi người sử dụng thuật ngữ định luật lũy thừa). Cứ cho là số lần xảy ra cao hơn một mức nhất là định nào đó là “mức trội” (exceedance) - mức trội của hai triệu là số người có khối tài sản trị giá hơn hai triệu. Một thuộc tính chính của các phân dạng này (hay còn gọi là tính thang bậc) là tỷ lệ của hai mức trội[1] sẽ trở thành tỷ lệ của hai số đó trên lũy thừa âm của hàm mũ lũy thừa đó.
Chúng ta hãy minh họa điều này. Giả sử bạn “nghĩ” rằng chỉ có 96 cuốn sáchnăm bán được hơn 250.000 bản (theo số liệu của năm vừa rồi), và rằng số mũ đó vào khoảng 1,5. Bạn có thể tiến hành ngoại suy để đoán được rằng khoảng 34 cuốn sách sẽ bán được hơn 500.000 bản - đơn giản là 96 lần (500.000/250.000). Chúng ta có thể tiếp tục, và lưu ý rằng khoảng 8 cuốn sách bán được hơn 1 triệu bản, ở đây là 96 lần của (500.000/250.000)-1,5. Chúng ta có thể tiếp tục, và lưu ý rằng khoảng 8 cuốn sách phải bán được hơn 1 triệu bản, ở đây là 96 lần của 0.000.000/250.000)-1,5.
Minh họa 13: Mô hình thống kê phân dạng thuần túy
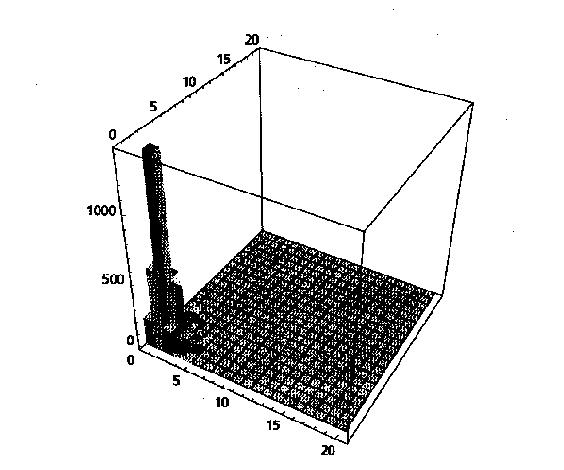
Mức độ bất công ở 16 phần phụ của biểu đồ đều bằng nhau. Trong thế giới Gauss, những chênh lệch về tài sản (hoặc bất kỳ khối lượng nào khác) sẽ giảm khi bạn nhìn vào giới hạn phía trên - vì thế các tỷ phú có sự tương đồng với nhau hơn so với các triệu phú, và các triệu phú có sự tương đồng với nhau hơn so với tầng lớp trung lưu. Nói tóm lại, sự thiếu công bằng này ở các mức tài sản chính là sự tự đồng dạng về thống kê.
Tôi xin chỉ ra các số mũ khác nhau đối với một chuỗi các hiện tượng.
Xin nói thẳng rằng các số mũ này không có nhiều ý nghĩa về độ chính xác của các con số. Chúng ta chứng kiến ngay đây, nhưng lúc này hãy lưu ý rằng chúng ta không quan sát mà chỉ đoán các thông số này, hoặc suy đoán chúng cho các thông tin thống kê, điều nay đôi khi khiến chúng ta khó biết được các thông số thật sự - nếu như trên thực tế chúng có tồn tại. Trước tiên, chúng ta hãy kiểm tra các kết quả thực tế của một số mũ.
Bảng 2 minh họa tác động của cái gọi là “xác suất cực nhỏ, tác động cực lớn”. Nó thể hiện những đóng góp của các mức 1% và 20% vào tổng thể. Số mũ càng thấp thì các mức đóng góp này càng cao. Nhưng hãy nhìn vào mức độ nhạy cảm của quy trình này: với số mũ dao động giữa 1,1 và 1,3, mức đóng góp đó đã thay đổi từ 66% xuống 34% so với tổng thể. Chỉ chênh nhau 0,2 nhưng kết quả đã thay đổi một cách rõ rệt - và sự chênh lệch đó có thể là do sai số trong một phép đo đơn giản. Sự khác biệt này không phải là không đáng kể: giả sử rằng chúng ta không có khái niệm cụ thể nào về hàm số mũ đó vì không thể trực tiếp đo được nó. Tất cả những gì chúng ta phải làm là dự đoán từ dữ liệu quá khứ hoặc dựa trên những lý thuyết nào cho phép xây dựng được mô hình giúp chúng ta có được ý tưởng nào đó - nhưng những mô hình này có lẽ đã giấu đi các điểm yếu - những điểm giúp chúng ta không mù quáng áp dụng chúng vào thực tiễn cuộc sống.
Bảng 2: Số mũ được giả định cho các hiện tượng khác nhau
Hiện tượng Số mũ giả định
(độ xấp xỉ không chính xác)
Mức độ sử dụng thường xuyên của các từ 1,2
Số lượng kết quả thành công trên các trang web 1,4
Số lượng sách bán ra tại Mỹ 1,5
Số cuộc gọi nhận được 1,22
Mức độ ảnh hưởng của các trận động đất 2,8
Đường kính của các hình tròn trên mặt trăng 2,14
Cường độ của các vụ nổ giải phóng năng lượng 0,8
Phạm vi ảnh hưởng của các cuộc chiến 0,8
Trị giá tài sản của người Mỹ 1,1
Số ngườihọ 1
Dân số của các thành phố của Hoa Kỹ 1,3
Các biến động trên thị trường 3 (trở xuống)
Quy mô công ty 1,5
Số thương vong trong các cuộc tấn công khủng bố 2 (nhưng có thể thấp hơn rất nhiều)
Nguồn MEJ, Newman (2005) và các tính toán của tác giả này.
Bảng 3: Ý nghĩa của sỗ mũ
Số mũ Phần của nhóm 1 % dẫn đầu Phần của nhóm 2% dẫn đầu
1 99,99%* 99,99%
1,1 66% 86%
1,2 47% 76%
1,3 34% 69%
1,4 27% 63%
1,5 22% 58%
2 10% 45%
2,5 6% 38%
3 4,6% 34%
* Rõ ràng, bạn không quan sát 100% trong một ví dụ giới hạn.
Vì thế, hãy nhớ rằng hàm mũ 1,5 là một con số xấp xỉ, rằng nó khó tính toán, rằng nó không từ trên trời rơi xuống - ít nhất là không dễ dàng có được nó, và rằng bạn sẽ mắc phải một sai số lấy mẫu rất lớn. Bạn sẽ quan sát thấy rằng số lượng sách bán trên 1 triệu bản thường không bao giờ là 8 cuốn - nó có thể là 20 cuốn hoặc chỉ có 2 cuốn.
Quan trọng hơn, hàm mũ này bắt đầu ứng dụng với một con số được gọi là “crossover”, (chuỗi phối hợp để thay đổi giá trị và tạo ra các chuỗi mới trong vị trí của chúng) và chỉ ra những con số lớn hơn chuỗi phối hợp này. Có lẽ nó bắt đầu với 200.000 cuốn sách, hoặc có lẽ chỉ 400.000 cuốn.
Tương tự, tài sản cũng có nhiều thuộc tính khác nhau hơn - ví dụ 600 triệu đô-la, khi sự bất bình đẳng gia tăng - so với mức dưới một con số như thế. Làm cách nào bạn biết được điểm “crossover” nằm ở đâu? Đây là một vấn đề. Tôi và các đồng nghiệp của mình đã làm việc với khoảng 20 triệu mẫu dữ liệu tài chính. Tất cả đều có cùng một tập hợp dữ liệu, tuy nhiên, chúng tôi không bao giờ thống nhất một cách chính xác được hàm mũ nào có trong các tập hợp dữ liệu của mình. Chúng tôi biết rằng các dữ liệu đó đã tiết lộ một định luật lũy thừa fractal, nhưng hiểu rằng không ai có thể đưa ra một con số chính xác. Nhưng việc biết rõ - rằng sự phân phối đó có tính thang bậc và phân dạng - cũng đủ để cho chúng tôi vận hành và đưa ra các quyết định.
Một số người đã nghiên cứu và chấp nhận mức phân dạng “đến một điểm”. Họ tranh luận rằng tài sản, doanh số bán sách, và lợi nhuận thị trường đều có một mức nhất định khi mọi thứ không còn phân dạng nữa. “Sai số cụt” (truncation) là những gì họ đã đề xuất. Tôi đồng ý rằng có một mức nơi tính phân dạng có thể sẽ dừng lại, nhưng là mức nào? Việc nói rằng có một giới hạn trên nhưng tôi không biết nó cao đến mức nào, và việc nói rằng không có giới hạn nào chứa các hậu quả giống nhau trên thực tế. Việc đề xuất một giới hạn trên là hết sức không an toàn. Bạn có thể nói, hãy phân tích mức tài sản cao nhất trị giá 150 tỷ đô-la. Sau đó, một người khác cũng có thể nói, “Sao không phải là 151 tỷ đô-la”? Hay “Sao không phải là 152 tỷ đô-la”? Chúng ta cũng có thể xét đến trường hợp biến số đó là không giới hạn.
Hãy cẩn thận về độ chính xác
Tôi đã học được một vài thủ thuật từ các trải nghiệm: bất kỳ số mũ nào tôi cố đo cho được đều có thể bị đánh giá quá cao (hãy nhớ lại rằng một số mũ cao sẽ có vai trò thấp đối với các độ lệch lớn) - những gì bạn nhìn thấy có thể không mang yếu tố Thiên Nga Đen hơn những gì bạn không nhìn thấy. Tôi gọi đây là bài toán ngụy trang (the masquerade problem).Giả sử tôi tạo ra một quy trình có một số mũ là 1,7. Bạn không nhìn thấy những thứ bên trong công cụ đó, chỉ thấy dữ liệu xuất hiện. Nếu tôi hỏi bạn số mũ đó là gì, nhiều khả năng bạn sẽ tính toán được ra một con số đại loại 2,4. Bạn sẽ vẫn làm thế dù có cả triệu điểm dữ liệu. Nguyên nhân là do phải mất một thời gian dài thì một số quy trình phân dạng mới bộc lộ các thuộc tính của chúng, và bạn sẽ đánh giá thấp mức độ nghiêm trọng của cú sốc đó.
Đôi khi, một phân dạng có thể khiến bạn tin rằng nó là đường cong Gauss, đặc biệt khi điểm cắt bắt đầu ở một con số lớn hơn. Với chức năng đo lường phân phối xác suất ngẫu nhiên, các độ lệch cực đại kiểu đó sẽ đủ hiếm để “hun khói” bạn: bạn không nhận ra được sự phân phối đó là một phân dạng.
Trở lại với vũng nước
Như bạn đã thấy, chúng ta gặp khó khăn trong việc biết về các thông số của bất kỳ mô hình nào được cho là vận hành thế giới. Vì thế, với Extremistan, bài toán quy nạp lại xuất hiện, lần này thậm chí còn ở mức đáng kể hơn so với bất kỳ thời điểm nào trước đó trong cuốn sách này.Đơn giản, nếu là phân dạng, một cơ chế có thể tạo ra các giá trị lớn; do đó, phạm vi ảnh hưởng của các độ lệch lớn là có thể xảy ra, nhưng rất khó biết được chính xác mức độ ảnh hưởng và chu kỳ xảy ra của chúng. Điều này giống với bài toán về vũng nước: vũng nước đó có thể được tạo ra từ nhiều viên đá. Là một người đi từ thực tế đến các mô hình giải thích khả thi, tôi đối mặt với một khối lượng vấn đề hoàn toàn khác với những người đi theo quy trình ngược lại.
Tôi chỉ đọc ba cuối sách “khoa học đại chúng” tóm tắt về nghiên cứu đó trong các hệ thống phức tạp: Tính phổ cập của Mark Buchanan, Critical Mass (Khối lượng tới hạn) của Philip Ball, và Why Most Things Fail (Vì sao hầu hết mọi thứ đều thất bại) của Paul Ormerod. Ba tác giả này thể hiện thế giới khoa học xã hội như là một nơi chứa đầy định luật lũy thừa, một quan điểm mà tôi hầu như hoàn toàn đồng ý. Họ cũng tuyên bố rằng ở đó có tính vạn vật (universality) của nhiều trong số các hiện tượng này, rằng có một sự tương đồng tuyệt vời giữa các quy trình khác nhau trong tự nhiên và hành vi của các nhóm xã hội, điều mà tôi cũng tán thành. Trong các nghiên cứu của mình, họ dẫn chứng bằng nhiều lý thuyết về các mạng lưới và chỉ ra được sự tương ứng tuyệt vời giữa các hiện tượng được coi là quyết định trong khoa học tự nhiên và tổ chức tự thân của các nhóm xã hội. Họ kết hợp các quy trình tạo ra hình thác nước, những ảnh hưởng xấu trong xã hội, và những thứ họ gọi là các thác nước thông tin - điều mà tôi cũng đồng ý.
Tính vạn vật là một trong những nguyên nhân khiến các nhà vật lý học nhận thấy định luật lũy thừa có liên quan đến các điểm tới hạn là điều đặc biệt thú vị. Ở đây có nhiều tình huống, cả trong lý thuyết các hệ thống động lực lẫn cơ học thống kê, nơi mà nhiều thuộc tính của động lực học quanh các điểm tới hạn đều phụ thuộc vào các chi tiết của hệ thống động lực cơ bản đó. Số mũ ở điểm tới hạn có thể giống đối với nhiều hệ thống trong cùng nhóm, cho dù nhiều khía cạnh khác của hệ thống đó có khác biệt đi nữa. Tôi hầu như đồng ý với khái niệm về tính vạn vật này. Rốt cuộc, cả ba tác giả đều khuyến khích chúng ta ứng dụng các kỹ thuật của vật lý thống kê, né tránh toán kinh tế và các phân phối không mang tính thang bậc theo kiểu đường cong Gauss như tránh dịch bệnh, và tôi vô cùng đồng ý với họ.
Nhưng bằng cách sản sinh và tăng cường độ chính xác, cả ba tác giả đều rơi vào cái bẫy của việc không phân biệt được giữa quy trình hướng về phía trước và quy trình ngược về sau (giữa vấn đề này và một vấn đề ngược lại với nó) - đối với tôi, đây chính là tội lỗi lớn nhất về khoa học và nhận thức luận. Nhưng không chỉ riêng ba tác giả này; hầu như những ai làm việc với các dữ liệu nhưng không đưa ra quyết định dựa trên những dữ liệu đó đều có xu hướng mắc cùng tội lỗi này - một biến thể của lối liên tưởng ngụy biện. Khi không có một quy trình phản hồi, bạn nhìn vào các mô hình và cho rằng chúng chứng thực cho thực tại. Tôi tin vào ý tưởng của ba cuốn sách này, nhưng không tin tưởng vào cách chúng được sử dụng - và dĩ nhiên là không tin vào độ chính xác mà các tác giả gán cho chúng. Trên thực tế, lý thuyết về độ phức tạp cần phải khiến cho chúng ta nghi ngờ hơn đối với các tuyên bố khoa học về các mô hình thực tiễn chính xác. Nó không khiến cho tất cả các thiên nga đều có màu trắng, và là thứ có thể dự đoán được: nó chỉ khiến cho thiên nga có màu xám, và chỉ màu xám mà thôi.
Như tôi đã nói trước đó, về mặt nhận thức luận, thế giới đúng là một nơi hoàn toàn khác đối với một người theo chủ nghĩa kinh nghiệm từ dưới lên. Chúng ta không có sự xa xỉ được ngồi xuống để đọc phương trình chi phối hành tinh này, mà chỉ quan sát dữ liệu và đưa ra giả định về quy trình thật sự của nó, và “định cỡ” bằng cách điều chỉnh phương trình của mình theo thông tin bổ sung. Khi các sự kiện tự xuất hiện trước chúng ta, chúng ta sẽ so sánh những gì nhìn thấy với những gì được mong đợi nhìn thấy. Đó luôn là một quy trình xoàng xĩnh, đặc biệt đối với những ai nhận thức được lối liên tưởng ngụy biện, để phát hiện ra rằng lịch sử di chuyển về phía trước chứ không phải ngược về sau. Người ta cho rằng các doanh nhân là những người rất có tính tự trọng cao, nhưng khi nhắc đến sự khác biệt giữa quyết định và kết quả, giữa các mô hình chính xác và thực tiễn, họ cũng dễ dàng bị bẽ mặt.
Những gì tôi muốn nói là sự mờ đục, sự không hoàn chỉnh của thông tin, sự vô hình của những gì tạo ra thế giới. Lịch sử không cho chúng ta nhìn thấy suy nghĩ của nó - chúng ta cần phải đoán những gì bên trong nó.
Từ mô tả đến thực tế
Ý tưởng trên kết nối tất cả các phần của cuốn sách này. Trong khi nhiều người nghiên cứu về tâm lý học, toán học hay thuyết tiến hóa và tìm cách áp dụng vào kinh doanh thì tôi xin đề xuất điều hoàn toàn ngược lại: hãy nghiên cứu tính bất định mạnh mẽ chưa được thể hiện trên thị trường như một phương tiện để hiểu biết sâu sắc về bản chất của sự ngẫu nhiên được ứng dụng trong tâm lý học, xác suất, toán học, lý thuyết ra quyết định (decision theory), và thậm chí vật lý thống kê. Bạn sẽ nhìn thấy được những biểu hiện không trung thực của lối liên tưởng ngụy biện, ngụy biện trò chơi, và những sai sót lớn của chủ quan kiến thức Plato từ cách mô tả cho đến thực tế.Lần đầu tiên khi gặp Mandelbrot, tôi đã hỏi ông vì sao một nhà khoa học có uy tín như ông hẳn phải có nhiều thứ giá trị hơn để làm lại quan tâm đến một chủ đề tầm thường như tài chính. Tôi cho rằng tài chính và kinh tế chỉ là nơi người ta học hỏi từ các hiện tượng thực nghiệm và làm đầy tài khoản ngân hàng của mình trước khi tính đến những việc tốt đẹp và to tát hơn. Mandelbrot trả lời rằng “Dữ liệu, đó là một mỏ vàng dữ liệu”. Quả thực, mọi người quên rằng ông bắt đầu với kinh tế học trước khi chuyển sang vật lý và hình học tự nhiên. Làm việc với nguồn dữ liệu dồi dào như thế khiến chúng ta thấy mình trở nên xoàng xĩnh; nó mang đến khả năng hiểu biết bằng trực giác về sai sót sau: đi sai hướng trên con đường giữa mô tả và thực tế.
Bài toán về một phân môn nhỏ của thống kê học có liên quan đến dữ liệu mang tính chu kỳ - circular statistics - (mà chúng ta cũng có thể gọi là luận cứđối số hồi quy thống kê - statistical regress argument) như sau. Ví dụ, bạn cần các dữ liệu quá khứ để biết một phân phối xác suất là thuộc đường cong Gauss, phân dạng hay một thứ gì khác. Bạn cần phải biết mình có đủ dữ liệu để hỗ trợ cho tuyên bố của mình hay không. Làm thế nào biết được chúng ta có đủ dữ liệu hay không? Từ sự phân phối xác suất đó - một phân phối sẽ nói cho bạn biết là có đủ dữ liệu để “tạo sự tự tin” về những gì bạn sắp suy luận. Nếu đó là đường cong hình chuông Gauss thì chỉ cần một vài điểm là đủ (một lần nữa luật số lớn). Và làm thế nào biết được sự phân phối đó là đường cong Gauss? Chính là từ dữ liệu. Vì thế, chúng ta cần có dữ liệu để biết phân phối xác suất đó là gì, và một phân phối xác suất sẽ cho chúng ta biết mình cần bao nhiều dữ liệu. Điều này gây ra một đối số hồi quy khốc liệt.
Sự hồi quy này sẽ không xảy ra nếu bạn giả định trước rằng sự phân phối đó thuộc đường cong Gauss. Vì một lý do nào đó, có thể đường cong Gauss sẽ tạo ra các thuộc tính của nó một cách dễ dàng. Điều này không xảy ra với các phân phối thuộc Extremistan. Vì thế, việc chọn đường cong Gauss trong khi dẫn chứng bằng một quy luật chung nào đó có vẻ như sẽ diễn ra thuận lợi. Đường cong Gauss được dùng như một phân phối mặc định vì chính nguyên nhân đó. Như tôi đã nhắc đi nhắc lại, việc giả định trước được ứng dụng của đường cong này có thể có tác dụng với một số lĩnh vực nhỏ như thống kê về tội phạm, tỷ lệ tử vong, những vấn đề thuộc Mediocristan, nhưng không dành cho các dữ liệu lịch sử về những đặc tính ẩn và những vấn đề thuộc Extremistan.
Vậy sao các nhà thống kê làm việc với các dữ liệu lịch sử lại không nhận biết về vấn đề này? Thứ nhất, họ không muốn nghe rằng toàn bộ công việc của họ đã bị trì hoãn bởi một tài toán quy nạp. Thứ hai, họ không phải đối mặt với kết quả dự đoán của mình trong những hoàn cảnh khắc nghiệt. Như chúng ta đã chứng kiến ở cuộc thi Makridakis, các nhà thống kê đều dựa vào lối liên tưởng ngụy biện, nhưng lại không muốn nghe về nó.
❀ ❀ ❀
[1] [] Bằng cách sử dụng tính đối xứng, chúng ta cũng có thể kiểm tra các phạm vi ảnh hưởng phía dưới số đó.


