Ở một mức độ nào đó, ông Zuckerberg đã đúng. Đối với nghiên cứu AI, lợi thế quan trọng mà Trung Quốc có là tài nguyên dữ liệu, vì mật độ người tỷ lệ thuận với mật độ dữ liệu. Với hơn 900 triệu dân số là người dùng internet, cộng với sự phổ biến và áp dụng các ứng dụng trong thời kỳ bùng nổ nền kinh tế di động, dữ liệu về thị trường tiêu dùng của Trung Quốc đã có sự tăng trưởng mạnh mẽ. Trong thị trường “di động đầu tiên” và “chỉ dành cho thiết bị di động” này, mọi người sử dụng điện thoại di động của họ rất nhiều để mua sắm hàng tiêu dùng, đặt giao bữa ăn, mua vé xem phim và thanh toán cho hầu hết các hoạt động hàng ngày, do đó, để lại một lượng lớn dữ liệu trên các nền tảng internet.
Ture, đối với cuộc đua AI, lợi thế lớn của Trung Quốc nằm ở Dữ liệu lớn mà nước này có. Nhưng lợi thế của nó là tinh tế hơn thế. Nền tảng là đối với tất cả những tiến bộ của nó, AI vẫn rất giả tạo như biệt danh của nó gợi ý. AI phải được “đào tạo” hoặc “dạy dỗ” về khả năng nhận thức của nó. Thuật toán AI phải xử lý một lượng lớn ảnh và video được gắn thẻ trước khi nhận ra rằng một con mèo đen và một con mèo trắng đều là mèo. Tương tự như vậy, để học cách phân biệt giữa mèo và chó, máy tính phải được hiển thị hình ảnh trong đó mỗi con vật được dán nhãn chính xác. Đối với quy trình đào tạo đó (xem Hình 8.1 ), thông tin như ảnh và video phải được thu thập và các chi tiết liên quan đến đối tượng—ví dụ: mèo hoặc chó—cần được dán nhãn để cho máy biết những gì chúng đang nhìn thấy (trong trong tương lai, máy móc có thể trở nên đủ thông minh để tự dạy mình).
Do đó, dữ liệu đơn thuần không được sử dụng nhiều để phát triển AI. Trước tiên chúng phải được dán nhãn. Sự bùng nổ nhu cầu về dữ liệu để huấn luyện các thuật toán AI đang nuôi dưỡng một ngành công nghiệp toàn cầu mới—“thu thập và ghi nhãn dữ liệu”. Đó là lý do tại sao các công ty khởi nghiệp về nhà máy dữ liệu mọc lên ở Trung Quốc, thường là ở các thành phố tương đối nhỏ hơn, rẻ hơn nơi mà cả lao động và không gian văn phòng đều rẻ. Nhiều công nhân của nhà máy dữ liệu là những người đã từng làm việc trên dây chuyền lắp ráp và công trường xây dựng ở những thành phố lớn đó.
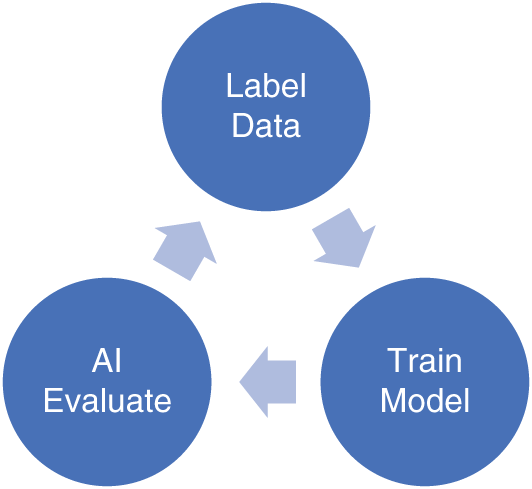
Hình 8.1 AI được cung cấp trên dữ liệu được dán nhãn
Đối với nhân viên dán nhãn, công việc không phải là kỹ thuật cao và có thể nhàm chán. Công việc thường là đánh dấu các điểm dữ liệu trên ảnh chụp người, cảnh quay giám sát và đường phố. Ví dụ, dán nhãn hình ảnh của những người đang buồn ngủ có thể được sử dụng bởi các dự án lái xe tự trị để xác định những người lái xe đang ngủ gật khi lái xe. Tuy nhiên, công việc dữ liệu mới mang lại cho họ sự phấn khích khi trở thành công nhân xây dựng trong thế giới kỹ thuật số và ngành công nghiệp mới mang lại một số lợi ích việc làm của lĩnh vực công nghệ cho các vùng nông thôn.
Do đó, Trung Quốc đã nổi lên như một trung tâm toàn cầu quan trọng để thu thập và dán nhãn dữ liệu, nhờ dữ liệu dồi dào và lao động giá rẻ. Nếu dữ liệu trong nền kinh tế mới (không hoàn toàn chính xác) so với dữ liệu trong nền kinh tế cũ, thì các doanh nghiệp thu thập và ghi nhãn dữ liệu có thể được coi là nhà máy lọc dầu thô, biến dữ liệu thô thành nhiên liệu có thể sử dụng cho các ngành công nghiệp AI. Cũng giống như các nhà máy sản xuất quần jean và áo phông “Made in China” truyền thống, các nhà máy dữ liệu hoạt động hiệu quả và cạnh tranh về giá, đồng thời họ tự hào có sự kết hợp mạnh mẽ giữa các khách hàng trong nước và nước ngoài ở những nơi xa xôi như Hoa Kỳ, Mexico, Kenya, Ấn Độ , và Vê-nê-xu-ê-la.
Cuộc đua AI trong lĩnh vực nhận diện khuôn mặt là một ví dụ điển hình. Nền tảng của những kỳ lân Trung Quốc như Megvii và SenseTime là chuỗi cung ứng dữ liệu mà qua đó dữ liệu được thu thập, làm sạch và được dán nhãn trước khi được xử lý vào phần mềm học máy giúp nhận dạng khuôn mặt hoạt động. Nhiều thuật toán họ sử dụng không khác mấy so với các thuật toán khác. Cơ sở hạ tầng dán nhãn dữ liệu của Trung Quốc, không có đồng đẳng, là một yếu tố quan trọng để các công ty khởi nghiệp AI nổi bật. Trong tương lai, nhiều ngành công nghiệp truyền thống cũng sẽ được hưởng lợi từ chuỗi cung ứng máy học này khi họ trải qua quá trình chuyển đổi kỹ thuật số.
Do đó, vào năm 2020, chính quyền trung ương của Trung Quốc đã ban hành hướng dẫn chính sách kinh tế để đưa “dữ liệu” vào “các yếu tố sản xuất”, cùng với các yếu tố truyền thống như đất đai, lao động, vốn và công nghệ (xem Hình 8.2 ) . Chính phủ cho biết Trung Quốc đang ở giai đoạn quan trọng của sự phát triển dựa trên đổi mới và dữ liệu có thể có tác động cấp số nhân đối với hiệu quả của các yếu tố khác. Sáng kiến này phù hợp với chương trình “cơ sở hạ tầng mới” được công bố tại báo cáo của chính phủ trung ương tháng 5 năm 2020, trong đó tập trung vào các phát triển liên quan đến dữ liệu. Theo khuôn khổ này, việc quản lý và bảo vệ dữ liệu cá nhân, các tiêu chuẩn dữ liệu ngành thống nhất, chia sẻ dữ liệu công khai và riêng tư, trong số các vấn đề quan trọng khác của nền kinh tế kỹ thuật số, đang phát triển nhanh chóng.
Trong khi đó, tầm quan trọng ngày càng tăng của dữ liệu cũng dẫn đến sự xuất hiện của dữ liệu bất hợp pháp và dữ liệu giả mạo. “màu đen thị trường” cho dữ liệu bất hợp pháp đang nở rộ ở Trung Quốc, được thúc đẩy bởi số lượng lớn và giá rẻ. Số lượng hồ sơ dữ liệu trung bình liên quan đến vi phạm dữ liệu ở Trung Quốc cao hơn nhiều lần so với các quốc gia khác và thông tin tín dụng cá nhân và hồ sơ điện thoại có thể được mua với giá chỉ 0,01 đô la Mỹ, theo báo cáo của các phương tiện truyền thông. Chỉ cần tìm kiếm đơn giản như “dữ liệu điện thoại di động” hay “dữ liệu cá nhân” trên mạng xã hội, người ta có thể dễ dàng tìm thấy các nhóm được thành lập để mua bán thông tin cá nhân.
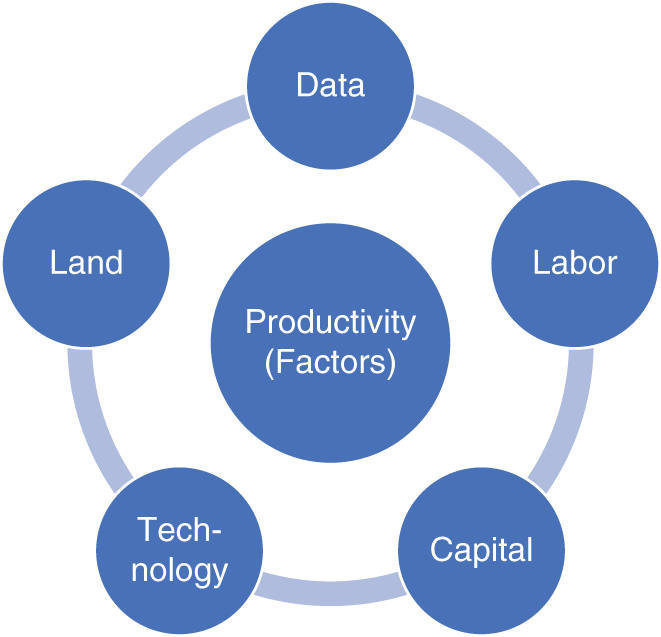
Hình 8.2 Dữ liệu: Phần bổ sung mới cho “yếu tố sản xuất”
Ngành công nghiệp dữ liệu giả mạo cũng đang nở rộ, đặc biệt là trong lĩnh vực truyền thông và giải trí, vì dữ liệu người dùng đồng nghĩa với sự nổi tiếng và tầm ảnh hưởng. Trên Weibo giống như Twitter của Trung Quốc, mức độ nổi tiếng của “những người nổi tiếng trên mạng” có thể được đo lường bằng số lượng người theo dõi họ, số lần bài đăng của họ được thích và vị trí của họ trong các danh sách xếp hạng khác nhau. Hơn nữa, vì hầu hết các nền tảng giải trí đều sử dụng thuật toán AI dựa trên dữ liệu để xác định nội dung nào sẽ đề xuất cho người dùng nên giá trị của dữ liệu có thể được gộp lại. Khi hoạt động kinh doanh dựa trên dữ liệu phát triển, cuộc chiến chống làm sai lệch dữ liệu và số liệu thống kê vẫn tiếp tục. ( Xem hộp “Quân đội dưới nước và Kris là ai?”.)
Thủy Quân và Kris Là Ai?
Vào thế kỷ 16, có những “claques” của Pháp—đám đông trả tiền để tán thưởng các buổi biểu diễn sân khấu. Trong thời đại internet, “đội quân dưới nước” thậm chí không cần đến con người. Theo báo cáo của công ty giám sát dữ liệu quảng cáo bên thứ ba Miaozhen Systems, gần một phần ba lưu lượng truy cập internet của Trung Quốc trong năm 2018 được đánh giá là “bất thường”, dẫn đến thiệt hại cho các nhà quảng cáo lên tới hơn 26 tỷ RMB (3,75 tỷ USD).
Đội quân nước trên internet là một nhóm các tài khoản giả được các công ty, người nổi tiếng và những người có ảnh hưởng sử dụng để thổi phồng lượng người theo dõi trên mạng xã hội của họ (hoặc chỉ trích đối thủ) — được gọi như vậy vì họ “đổ nước” vào các cuộc thảo luận trực tuyến. Cũng giống như trong thị trường thương mại điện tử, các nhà cung cấp giao dịch giả mạo ( shuaxiaoliang ) để thổi phồng khối lượng giao dịch của họ ( xem hộp “Bàn giảm khối lượng bán hàng ( Shuaxiaoliang )” trong Chương 2 ). Trong thị trường tiếp thị kỹ thuật số, người chơi có thể “đánh bật lưu lượng người dùng” ( shualiuliang ) để tạo ra hiệu ứng lan truyền.
Theo những câu chuyện trên phương tiện truyền thông trích lời một cựu nhân viên của một công ty công nghệ lớn của Trung Quốc, “Thuê quân đội dưới nước là một phần trong bộ công cụ của mọi nhà quản lý quan hệ công chúng”. Thật vậy, một tìm kiếm đơn giản trên bất kỳ công cụ tìm kiếm hoặc mạng xã hội nào cũng có thể tìm thấy một nguồn lớn các cơ quan quân đội nước. Các đại lý chuyên nghiệp cung cấp một loạt các dịch vụ. Ví dụ: trong cái mà họ gọi là gói cơ bản có giá khoảng 1,5 đô la Mỹ (10 RMB), người mua có thể có được 400 người theo dõi (người hâm mộ giả) trên Weibo hoặc 100 lượt chia sẻ của một bài đăng cụ thể. Ngoài ra còn có một loạt các ưu đãi được tùy chỉnh: chất lượng người theo dõi càng cao thì tài khoản có vẻ càng năng động và thực tế hơn—và dịch vụ càng đắt tiền.
Các nhà quảng cáo hiện đại phụ thuộc vào dữ liệu thị trường để quyết định đại sứ thương hiệu của họ cho quảng cáo trực tuyến. Tuy nhiên, hệ thống điều khiển dữ liệu trực tuyến này dễ bị khai thác bởi các nhà điều hành quân đội nước. “Những người có ảnh hưởng” giả mạo không có phạm vi tiếp cận thực sự và những người hâm mộ giả mạo không mua bất cứ thứ gì. Đối với các thương hiệu nước ngoài, văn phòng tại Trung Quốc của họ có thể chọn đại sứ thương hiệu dựa trên các số liệu được thổi phồng để thể hiện sự “tăng trưởng” liên tục của trụ sở chính. Nói tóm lại, lưu lượng người dùng giả mạo đã “làm xáo trộn nước” đối với các thương hiệu.
Sức mạnh của đội quân thủy bộ Trung Quốc thậm chí đã vươn ra thị trường nước ngoài. Vào ngày 5 tháng 11 năm 2018, Kris Wu, một rapper người Canada gốc Hoa, đã vượt qua Ariana Grande và Lady Gaga trong danh sách bán chạy nhất của iTunes. Trong phần lớn thời gian của ngày và đêm, ca khúc duy nhất không phải của Wu trong top 5 là “Thank U, Next” của Ariana Grande — bài hát mà Wu gợi ý là do những người hâm mộ trung thành của anh ấy chứ không phải bot. Nhưng không rõ làm cách nào mà người hâm mộ Trung Quốc có thể mua hàng trên các nền tảng của Hoa Kỳ. Khi Kris Wu thống trị bảng xếp hạng 10 bài hát hàng đầu của iTunes, nhiều người hâm mộ nhạc pop Hoa Kỳ đã hỏi, "Kris là ai?"
Tất nhiên, bản thân việc truy cập vào nhiều dữ liệu nhất không phải là yếu tố quan trọng nhất trong quá trình phát triển AI. Ví dụ: sau khi AlphaGo đánh bại kỳ thủ cờ vây giỏi nhất của con người, Google đã phát triển thêm một phiên bản cao cấp hơn, AlphaGo Zero, phiên bản này hoàn toàn không được đào tạo bởi dữ liệu lịch sử của các trò chơi giữa con người với nhau. Thay vào đó, AlphaGo Zero chỉ được dạy các quy tắc của trò chơi cờ vây trước khi nó bắt đầu tự luyện tập bằng cách chơi trò chơi với chính nó. Trong vòng vài ngày, AlphaGo Zero đã dễ dàng đánh bại AlphaGo. Rõ ràng, ngoài số lượng dữ liệu, các yếu tố khác như thuật toán mới, sức mạnh tính toán và loại dữ liệu có sẵn cũng có giá trị không kém.
Do đó, việc so sánh dữ liệu với dầu mới là một chút thiếu sót. Mối quan hệ giữa dữ liệu và năng lực AI tương tự như mối quan hệ giữa lao động và nền kinh tế. Trung Quốc có thể có lượng lao động dồi dào, nhưng chất lượng, cấu trúc và như trường hợp AlphaGo minh họa, việc quản lý (lập trình thuật toán) của lực lượng lao động đó cũng quan trọng không kém đối với sự phát triển kinh tế. So với kho dự trữ dữ liệu khổng lồ của Trung Quốc, Hoa Kỳ nắm giữ lợi thế về chất lượng dữ liệu và tính đa dạng của dữ liệu. Ví dụ, Facebook và WeChat của Trung Quốc đều có hơn một tỷ người dùng trên mạng xã hội của họ, nhưng người dùng Facebook đại diện cho nhiều ngôn ngữ, sắc tộc, văn hóa và quốc tịch hơn so với những người dùng sau này (chủ yếu là người Trung Quốc).
Tuy nhiên, trước khi các chương trình AI hoàn toàn trở thành phương pháp học tự giám sát hoặc không giám sát, trong đó các hệ thống AI học mà không cần con người dán nhãn, kho dự trữ dữ liệu của Trung Quốc và nhóm nhân viên dữ liệu lớn vẫn là một lợi thế quan trọng, cung cấp cho chu trình đạo đức của AI—nhiều dữ liệu hơn để thử nghiệm, nhiều hơn nữa Các sản phẩm AI để triển khai, nhiều dữ liệu được tạo lại từ việc sử dụng. Lợi thế đó đặc biệt có giá trị trong thời đại triển khai AI (khám phá trực tiếp) vì hầu hết các kỹ sư tập trung vào việc chạy và thử nghiệm các thuật toán AI trên “Dữ liệu lớn” để có tốc độ nhanh hơn, dự đoán tốt hơn, ít nhân công hơn, ít chi phí hơn, vv. .
Hơn nữa, các nhà máy dán nhãn của Trung Quốc đang tự nâng cấp vì dữ liệu người dùng tích hợp, quy mô lớn và chất lượng cao hiện đang được cung cấp dưới mức trên toàn cầu. Khi các công ty khởi nghiệp chuyển sang học sâu AI tiên tiến hơn, chính độ chính xác cao hơn của dữ liệu được dán nhãn giúp công ty phát triển thịnh vượng, thay vì giá thấp và lao động rẻ. Ví dụ: dữ liệu cho ô tô tự hành và máy đọc tia X yêu cầu kiến thức chuyên môn và nhiều người chơi ghi nhãn dữ liệu đang tự đặt ra cho mình những nhiệm vụ khó khăn hơn và tỷ suất lợi nhuận cao hơn. Khi ngành Dữ liệu lớn của Trung Quốc mở rộng, nhận thức về dữ liệu của công chúng tăng lên.