HỎI: Bạn có thể tạo ra bao nhiêu dòng tweet chỉ bằng tiếng Anh? Sẽ mất bao lâu để toàn bộ người trên thế giới đọc to tất cả những dòng tweet đó lên?
— Eric H. Hopatcong, NJ
Tại vùng Svithjod xa xôi về phương Bắc có một tảng đá sừng sững. Nó trải ra một trăm dặm dài, dựng đứng một trăm dặm cao. Cứ mỗi một nghìn năm, lại có một con chim nhỏ bay đến tảng đá đó để quẹt cho sắc mỏ. Khi tảng đá bị bào mòn hết thì một ngày vĩnh cửu sẽ trôi qua.
ĐÁP. Một dòng tweet dài 140 ký tự. Trong tiếng Anh có khoảng 26 chữ cái – có thể là 27,nếu bạn tính cả dấu cách. Sử dụng bảng chữ cái này ta có thể tạo ra 27140 ≈ 10200 chuỗi ký tự.
Nhưng Twitter không giới hạn cách bạn dùng các ký tự đó. Bạn có thể tùy ý sử dụng bảng mã Unicode với hơn một triệu các kiểu gõ ký tự khác nhau. Dù cách Twitter đếm số ký tự Unicode rất phức tạp, nhưng số chuỗi các ký tự khả dĩ có thể lên tới 10800.
Dĩ nhiên, phần lớn tất cả chúng sẽ là những mớ ký tự lộn xộn vô nghĩa từ hàng chục ngôn ngữ khác nhau. Thậm chí dù bị giới hạn chỉ với 26 chữ cái tiếng Anh nhưng những chuỗi ký tự này sẽ đầy những mớ lộn xộn vô nghĩa kiểu như “ptikobj.” Câu hỏi của Eric về các dòng tweet thực ra là phải nói về điều gì đó có nghĩa bằng tiếng Anh. Vậy có thể có bao nhiêu dòng tweet như vậy?
Đây quả là câu hỏi hóc búa. Yêu cầu đầu tiên của bạn là chỉ chấp nhận các từ tiếng Anh có nghĩa. Rồi sau đó là các câu đúng cấu trúc ngữ pháp. Nhưng như thế cũng thật khó. Ví dụ như, “Hi, I’m Mxyztplk” (xin chào, tôi là Mxyztplk) là một câu đúng cấu trúc ngữ pháp nếu tên ai đó đúng là Mxyztplk. (Hãy nghĩ mà xem, về ngữ pháp mà nói, câu này tương tự một câu nói dối vậy.) Rõ ràng, thật vô nghĩa khi tính đến chuỗi ký tự bắt đầu với “xin chào, tôi là…” như một câu riêng rẽ. Thường thì cách nói, “Xin chào, tôi là Mxyztplk” sẽ chẳng khác gì “Xin chào, tôi là Mxzkqklt”, và cả hai câu sẽ không được tính đến. Nhưng câu “Xin chào, tôi là xPoKeFaNx” chắc hẳn sẽ tạo cảm giác khác hẳn so với hai câu trước, dù cho “xPoKeFaNx” không bao giờ là một từ tiếng Anh dù trí tưởng tượng có phóng khoáng đến đâu.
Dường như không thể biết được câu nào là câu có nghĩa. Nhưng thật may, có một cách tiếp cận tốt hơn.
Hãy tưởng tượng có một ngôn ngữ chỉ gồm hai câu có nghĩa, và mỗi dòng tweet chỉ là một trong hai câu đó. Chúng là:
“Có một con ngựa ở gian số năm.” “Nhà tôi đặt đầy bẫy.”
Dòng tweet sẽ trông giống như thế này:
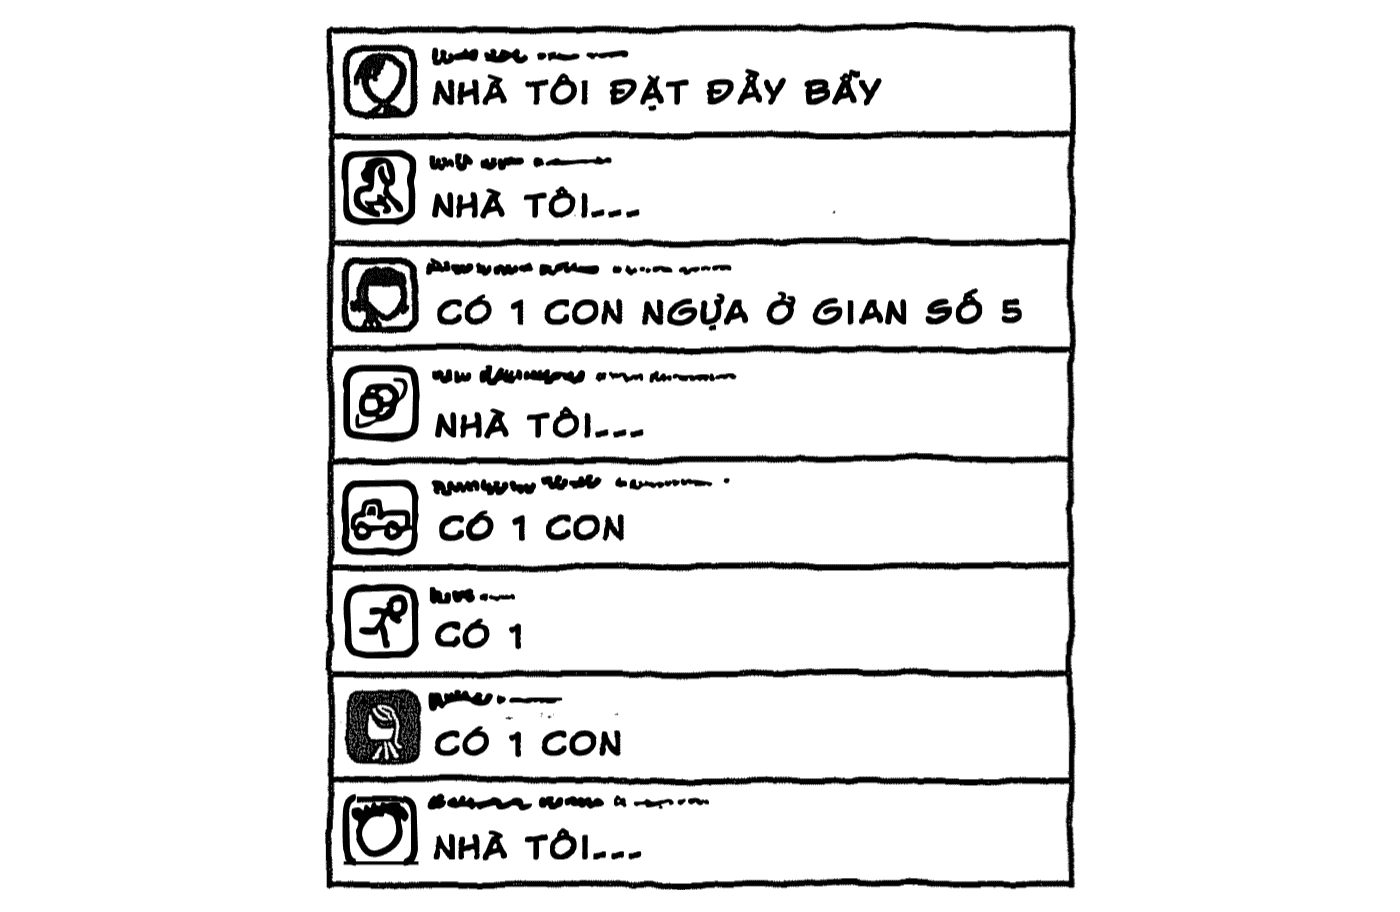
Các tin nhắn tương đối dài nhưng không có nhiều thông tin chứa đựng trong mỗi tin nhắn ấy – tất cả những gì bạn nhận được là thông tin về cái bẫy và con ngựa. Nó thực tế chính là 1 hoặc 0. Dù có nhiều chữ cái, nhưng đối với một người hiểu được cấu trúc của ngôn ngữ thì mỗi dòng tweet chỉ chứa đựng một bit thông tin trong một câu mà thôi.
Ví dụ này gợi ra một ý tưởng rất sâu sắc rằng thông tin về bản chất gắn liền với sự không chắc chắn của người nhận nội dung thông điệp và năng lực dự đoán nó của họ.[1]
Claude Shannon – người gần như đã một mình phát kiến ra lý thuyết thông tin hiện đại – đã có một phương pháp thông minh để tính hàm lưọng thông tin của một ngôn ngữ. Ông cho một nhóm người xem các mẫu văn bản tiếng Anh điển hình nhưng bị cắt bỏ ở một điểm ngẫu nhiên, sau đó ông yêu cầu họ đoán xem chữ cái nào sẽ xuất hiện kế tiếp.
Nó đang đe dọa nhấn chìm thị trấn của chúng ta bằng lượng thông tin!
Dựa trên tỷ lệ những dự đoán chính xác được đưa ra – và những phân tích toán học chặt chẽ – Shannon đã xác định được rằng hàm lượng thông tin chứa trong mỗi chữ viết tiếng Anh vào khoảng 1 đến 1,2 bit. Điều này nghĩa là một thuật toán nén dữ liệu tốt có khả năng nén văn bản ASCI viết bằng tiếng Anh – gồm 8 bit mỗi chữ cái – xuống mức chỉ bằng ⅛ kích cỡ ban đầu. Thực vậy, nếu bạn nén một ebook định dạng .txt bằng một công cụ nén tập tin tốt, thì bạn sẽ thấy điều đó.
Nếu một văn bản có chứa n bit thông tin, thì sẽ có 2n cách khác nhau truyền tải văn bản đó. Có một chút khôn khéo toán học ở đây (trong đó bao gồm cả độ dài của thông điệp và một thứ gọi là “khoảng cách unicity”), nhưng quan trọng là nó cho thấy có cỡ 2140x1,1 ≈ 2 × 1046 dòng tweet khác nhau viết bằng tiếng Anh có ý nghĩa, chứ không phải là 10200 hay 10800.
Vậy thì bây giờ sẽ mất bao lâu để cả thế giới đọc to tất cả chúng?
Để có thể đọc hết 2 × 1046 dòng tweet, một người phải mất 1047 giây. Đó là một số lượng dòng tweet khổng lồ đến mức dù là một người hay một tỷ người đọc cũng vậy mà thôi – chúng sẽ chẳng ảnh hưởng gì lắm đến thời gian đọc cỡ tuổi đời của Trái đất.
Thay vì thế, chúng ta hãy nghĩ đến hình ảnh chú chim quẹt mỏ trên đỉnh núi. Giả sử rằng chú chim ấy làm xước một vệt nhỏ trên tảng đá ở đỉnh núi mỗi lần ghé thăm sau hàng nghìn năm, và nó mang theo một chút bụi khi rời đi. (Một chú chim bình thường có lẽ sẽ vương lại lớp sừng mỏ trên đỉnh núi nhiều hơn lượng nó mang theo, nhưng thực ra thì kịch bản này vốn đã không bình thường, nên chúng ta sẽ cứ bỏ qua chi tiết đó đi vậy.)
Giả sử bạn đọc to các dòng tweet 16 giờ đều đặn mỗi ngày. Liền sau đó, cứ mỗi hàng nghìn năm, chú chim lại đến và mang đi một chút bụi từ đỉnh núi cao sừng sững đến hàng trăm dặm bằng chiếc mỏ của mình.
Khi ngọn núi bị bào mòn hết đi thì ngày vĩnh cửu đầu tiên cũng trôi qua.
Ngọn núi sẽ lại xuất hiện và chu kỳ mới lại bắt đầu với một ngày vĩnh cửu khác: 365 ngày vĩnh cửu – mỗi ngày vĩnh cửu này dài 1032 năm – làm nên một năm vĩnh cửu.
Một trăm năm vĩnh cửu, sau khi chú chim san phẳng 36.500 ngọn núi, tạo thành một thế kỷ vĩnh cửu.
Nhung một thế kỷ vẫn chưa đủ, một thiên niên kỷ lại càng không.
Để đọc hết tất cả các đoạn tweet bạn phải mất đến mười nghìn năm vĩnh cửu.
Khoảng thời gian này đủ để bạn quan sát toàn bộ lịch sử của loài người, kể từ khi chữ viết được phát minh cho đến nay, với mỗi ngày dài như quãng thời gian con chim quẹt mỏ để san bằng một ngọn núi.
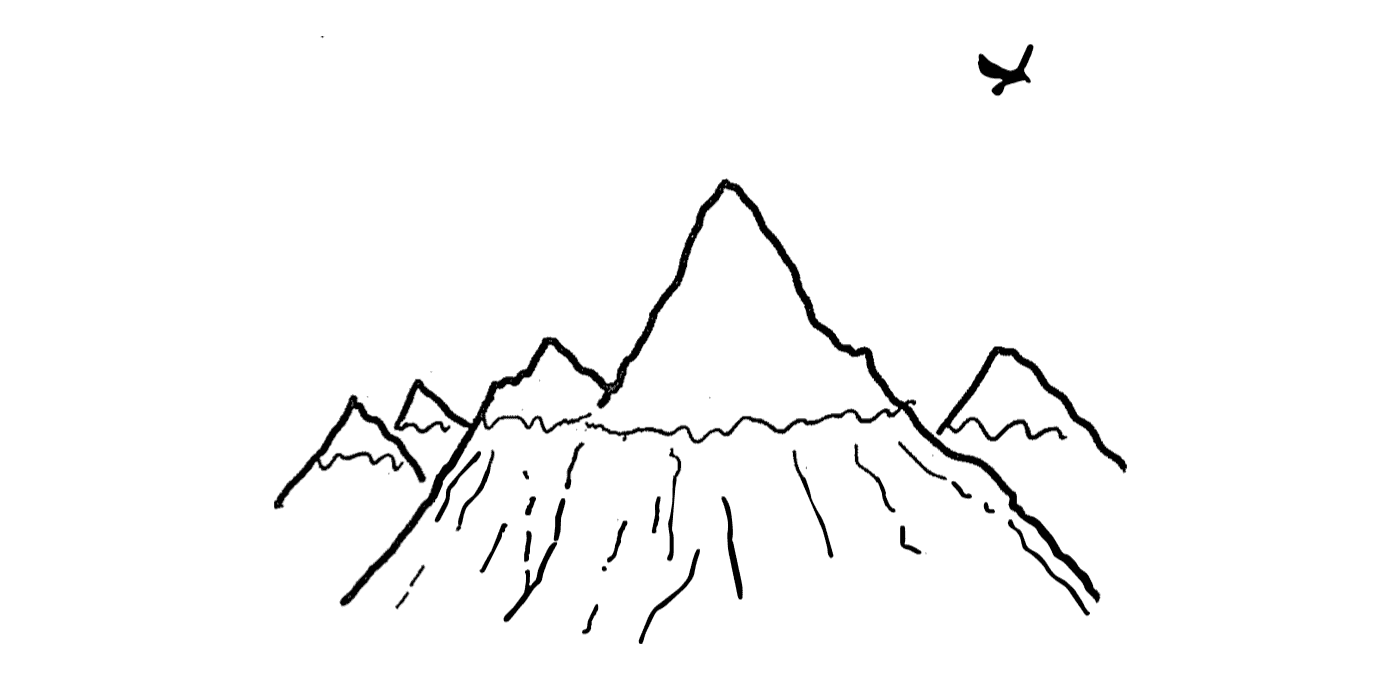
Xem ra 140 ký tự tuy không nhiều nhặn lắm, nhưng chúng ta lại sẽ không bao giờ hết chuyện để nói.
❀ ❀ ❀
[1] Tương tự, thang đo cường độ gió F (Fujita) đã được thay thế bằng thang EF (Fujita mở rộng). Đôi khi, một đơn vị đo trở nên lỗi thời bởi vì xài nó rất kinh khủng – chẳng hạn, “kip” (1.000 pound lực), “kcfs” (hàng nghìn foot khối mỗi giây), và “độ Rankine” (độ F trên độ không tuyệt đối). (Tôi đã phải đọc các bài báo kỹ thuật sử dụng các đơn vị này.) Những khi khác, bạn có thể nhận thấy rằng các nhà khoa học chỉ muốn có thứ gì đó để “chỉnh” mọi người.