Phương trình trung tâm: Tính mỏng manh là hòn đá luyện đan cục bộ trong vùng dưới giá trị K, vì thế ωB là tính mỏng manh bị bỏ sót mà ta đánh giá thông qua so sánh hai tích phân trong vùng dưới giá trị K để nắm bắt ảnh hưởng đối với đuôi trái:
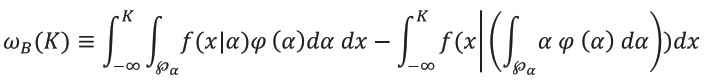
Đồng nhất thức trên đây có thể được tính xấp xỉ bằng một ước lượng nội suy với hai giá trị của α tách biệt với điểm giữa một đoạn bằng Aa, độ lệch trung bình của a và ước lượng
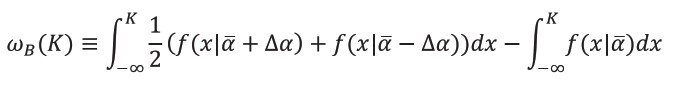
Lưu ý rằng khả năng cải thiện nghịch cảnh ωC là tích phân từ K đến vô tận. Ta có thể thăm dò ωB bằng các ước lượng điểm của hàm f ở mức X ≤ K
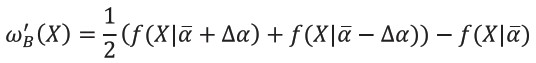
Cho nên
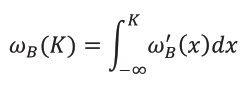
Điều này đưa ta đến với suy nghiệm để tìm tính mỏng manh (Taleb, Canetti, và những người khác., 2012). Nói cụ thể ra, nếu ta giả định rằng ω'B(X) có dấu không đổi ứng với X ≤ K, thì ωB (K) có cùng dấu. Khám phá suy nghiệm này là một sự nhiễu loạn ở đuôi để khảo sát tính mỏng manh, thông qua kiểm tra hàm ω'B (X) ở mức X bất kỳ.
BẢNG 12
| MÔ HÌNH | NGUYÊN NHÂN GÂY RA TÍNH MỎNG MANH | BIỆN PHÁP CỨU CHỮA |
| Lý thuyết danh mục đầu tư, trị trung bình- phương sai vv… | Kiến thức giả đinh về các thông số, không lấy tích phân mô hình giữa các thông số, dựa vào những mối tương quan (rất bất ổn). Giả định ωA (độ lệch) và ωB (tính mỏng manh) = 0. | 1/n (mở rộng số lượng liên lụy trong phạm vi có thể quản lý được), chiến lược hai đầu, tổ chức hữu cơ và tăng dần. |
| Lợi thế so sánh Ricardo | Bỏ sót lớp (layer) ngẫu nhiên trong giá rượu vang có thể dẫn đến đảo ngược hoàn toàn sự phân bổ. Giả đinh ωA (độ lệch) và ωB (tính mỏng manh) = 0. | Các hệ thống tự nhiên tự tìm cách phân bổ riêng thông qua chỉnh sửa. |
| Tối ưu hóa Samuelson | Tập trung các nguồn ngẫu nhiên khi hàm số thiệt hại có dạng lõm. Giả đinh ωA (độ lệch) và ωB (tính mỏng manh) = 0. | Ngẫu nhiên phân tán |
| Không gian trạng thái mạng Arro-Debreu | Ngụy biện trò chơi: Giả đinh am hiểu thấu đáo về các kết quả và am hiểu về xác suất. Giả đinh ωA (độ lệch) và ωB (tính mỏng manh), và ωC (khả năng cải thiện nghich cảnh) = 0. | Sử dụng siêu xác suất làm thay đổi hoàn toàn ý nghĩa của mô hình |
| Các mô hình luồng tiền mặt cổ tức (dividend cash flow model) | Bỏ sót tính ngẫu nhiên gây ra hiệu ứng lồi. Chủ yếu xem ωC (khả năng cải thiện nghich cảnh) = 0. | Suy nghiệm |
Áo tưởng danh mục đầu tư: Lưu ý một ảo tưởng được quảng bá bỏi những người sử dụng lý thuyết Markowitz: Lý thuyết danh mục đầu tư xui người ta đa dạng hóa, thế còn tốt hơn là chẳng có gì. Sai, bạn đầu tư hoài công: nó thúc đẩy bạn tối ưu hóa, qua đó bạn sẽ phân bổ đầu tư quá nhiều. Nó không xui khiến người ta chấp nhận ít rủi ro hơn dựa vào đa dạng hóa, mà nó làm cho họ có các trạng thái đầu tư mở do nhận thức về các thuộc tính thống kê bù trừ, làm cho họ trỏ nên dễ tổn thương trước sai số mô hình, và nhất là tổn thương trước sự ước lượng quá thấp các biến cố đuôi. Để tìm hiểu điều này diễn ra như thế nào, ta hãy xem thử hai nhà đầu tư đứng trước sự chọn lựa phân bổ giữa ba khoản mục đầu tư: tiền mặt, chứng khoán A và chứng khoán B. Nhà đầu tư thứ nhất không am hiểu thuộc tính thống kê của A và B, đồng thời cũng biết mình không am hiểu, nên sẽ giữ phần tiền mà mình không muốn mất dưới dạng tiền mặt, chỗ còn lại phân bổ đầu tư vào chứng khoán A và B - theo suy nghiệm truyền thống nào đó. Nhà đầu tư thứ hai, nghĩ rằng mình am hiểu các thuộc tính thống kê, với các thông số σA, σB, ρA,B, sẽ phân bổ ωA, ωB, sao cho tổng rủi ro đạt một mức mục tiêu nào đó (ta bỏ qua lợi nhuận kỳ vọng cho mục tiêu này). Nhà đầu tư càng cho rằng mối tương quan ρA,B, là thấp, thì sự liên lụy với sai số mô hình của anh càng tệ. Giả sử anh nghĩ rằng mối tương quan ρA,B, bằng 0, anh sẽ phân bổ đầu tư tăng thêm hơn 1/3 vào các biến cố cực độ. Nhưng nếu nhà đầu tư tội nghiệp có ảo tưỏng tương quan là -1, anh sẽ phân bổ đầu tư tối đa vào chứng khoán A và B. Nếu nhà đầu tư sử dụng đòn bẩy tài chính, ta sẽ kết thúc bằng câu chuyện (phá sản) của Quỹ Quản lý vốn dài hạn, cuối cùng hóa ra là bị lừa bỏi các thông số. (Trong đòi sống thực tế, không như các bài báo kinh tế, sự việc có xu hướng thay đổi; lạy thần Baal, sự việc thay đổi!) Chúng ta có thể lặp lại ý tưỏng này với từng thông số σ và thấy, nhận thức về giá trị thông số σ thấp hơn sẽ dẫn đến phân bổ đầu tư quá nhiều.
Từng là một nhà giao dịch, tôi nhận thấy, và ám ảnh với ý tưởng này, rằng các tương quan không bao giờ như nhau trong những lần đo khác nhau. Nếu nói bất ổn thì vẫn còn nhẹ: tương quan 0,8 suốt một thời gian dài trở thành -0,2 suốt một thời gian dài khác. Đó thuần túy là canh bạc của kẻ ngốc. Vào những lúc căng thẳng, các tương quan còn thay đổi đột ngột hơn mà chẳng có chút điều độ nào, bất chấp những nỗ lực lập mô hình “tương quan căng thẳng”. Taleb (1997) đã xem xét ảnh hưởng của các tương quan ngẫu nhiên: tốt hơn hết ta nên bán khống ở tương quan bằng 1 cho an toàn, và mua vào ở tương quan -1; điều này xem ra tương ứng với kết quả của quy tắc suy nghiệm 1/n.
Tiêu chí Kelly so với Markowitz: Để thực hiện việc tối ưu hóa hoàn toàn theo kiểu Markowitz, ta cần biết toàn bộ hàm phân phối xác suất kết họp của tất cả các tài sản trong toàn bộ tương lai, cộng với hàm thỏa dụng chính xác của của cải tại mọi thời điểm tương lai. Và không có sai số! (Ta đã thấy sai số mô hình làm cho hệ thống nổ tung.) Phương pháp của Kelly, triển khai vào khoảng cùng thời gian này, không đòi hỏi phải có hàm phân phối xác suất kết họp hay hàm thỏa dụng gì cả. Trong thực hành, ta cần biết tỷ số lợi nhuận kỳ vọng trên lợi nhuận của tình huống xấu nhất (worst-case returrn) - được điều chỉnh năng động để tránh phá sản. Trong trường họp biến đổi theo chiến lược hai đầu, tình huống xấu nhất sẽ được bảo hiểm. Và sai số mô hình sẽ nhẹ hơn nhiều theo tiêu chí Kelly. Thorp (1971, 1998), Haigh (2000).
Aaron Brown ghê góm cho rằng ý tưởng của Kelly bị các nhà kinh tế học bác bỏ - bất chấp sức hút về mặt thực hành - do họ yêu mến các lý thuyết phổ quát về định giá tài sản.
Lưu ý rằng việc thử nghiệm và sửa sai có giới hạn thì tương thích với tiêu chí Kelly khi ta có ý tưởng về lợi nhuận tiềm năng - ngay cả khi ta không biết về lợi nhuận, nhưng nếu thua lỗ được hạn chế, thì kết quả vẫn vững chắc và phương pháp này sẽ mang lại kết quả tốt hơn so với phương pháp của fragilista Markowitz.
Tài chính công ty: Nói vắn tắt, tài chính công ty xem ra dựa vào dự báo điểm chứ không phải dự báo phân phối; vì thế, nếu ta làm xáo trộn dự báo dòng tiền, ví dụ như trong mô hình định giá Gordon, thay thế tăng trưởng cố định và biết trước (hay các thông số khác) bằng những bước nhảy biến thiên liên tục (nhất là trong phân phối đuôi béo), thì những công ty có vẻ “đắt đỏ”, hay những công ty có tăng trưởng cao nhưng thu nhập thấp, có thể có giá trị kỳ vọng gia tăng đáng kể; điều này được thị trường định giá một cách suy nghiệm chứ không có lý lẽ cụ thể.
Kết luận và tóm tắt: Điều mà bộ môn kinh tế học thường bỏ sót là, tuy có một mô hình đúng (vốn là một giả định vô cùng hào phóng) nhưng không chắc chắn về các thông số thì tất yếu sẽ dẫn tới gia tăng tính mỏng manh trong những trường họp mối quan hệ có dạng lồi hay phi tuyến tính.
Bây giờ tới phần chủ yếu: Ngoài lĩnh vực kinh tế học, ta sẽ thảo luận về vấn đề tổng quát hơn với xác suất và độ đo sai.
Đuôi béo (Ngẫu nhiên cực độ) đi từ mối quan hệ phi tuyến đến các thông số mô hình như thế nào
Các biến cố hiếm hoi có một thuộc tính nhất định - thường không được chú ý tới cho đến nay, thời điểm viết quyển sách này. Chúng ta xử lý các biến cố này bằng một mô hình, một thiết kế toán học máy móc, trong đó ta nhập các thông số đầu vào và tính được các xác suất đầu ra. Tính bất định của thông số trong mô hình dùng để tính xác suất càng cao, thì các xác suất nhỏ càng có xu hướng được ước lượng quá thấp. Nói đơn giản, các xác suất nhỏ có dạng lồi theo sai số tính toán, giống như việc đi máy bay có dạng lõm theo sai số và độ nhiễu (nên nhó, thời gian đi máy bay chỉ kéo dài hơn chứ không rút ngắn đi.) Nguồn nhiễu loạn mà ta quên xem xét đến càng nhiều, thì thời gian đi máy bay càng kéo dài hơn so với giá trị ước lượng ngây tho.
Ai cũng biết, để tính xác suất bằng phân phối thống kê chuẩn chuẩn hóa (standard statistical normal distribution), ta cần một thông số gọi là độ lệch chuẩn (standard deviation) - hay một thông số tương tự mô tả độ phân tán các kết quả. Nhưng tình trạng không chắc chắn về độ lệch chuẩn khiến cho xác suất nhỏ tăng lên. Ví dụ, ứng với độ lệch được gọi là “ba sigma,” những biến cố chỉ diễn ra không hơn một lần trong số 740 quan sát, thì xác suất sẽ tăng thêm 60% nếu ta tăng độ lệch chuẩn thêm 5%, và xác suất sẽ giảm 40% nếu ta giảm độ lệch chuẩn 5%. Như vậy, nếu sai số bình quân chỉ là 5%, ước lượng từ mô hình ngây thơ là vào khoảng 20%. Vô cùng phi đối xứng, nhưng vẫn chưa đến nỗi nào. Tình hình sẽ trở nên tệ hơn nếu ta xem xét những độ lệch nhiều hơn, như “sáu sigma” (than ôi, đó là chuyện thường ngày trong kinh tế học): sự gia tăng gấp năm lần. Biến cố càng hiếm hoi (nghĩa là “sigma” càng cao), ảnh hưởng của bất định nhỏ ở thông số đầu vào của phương trình càng tệ hại. Với những biến cố như “mười sigma”, chênh lệch là hơn 1 tỷ lần. Ta có thể sử dụng lập luận này để thấy xác suất càng nhỏ càng đòi hỏi phải chính xác nhiều hơn trong việc tính toán. Xác suất càng nhỏ, việc làm tròn số rất nhỏ trong tính toán sẽ càng làm cho tính phi đối xứng trở nên vô nghĩa. Đối với những xác suất rất nhỏ, bạn cần có sự chính xác gần như vô hạn trong các thông số; chỉ một chút xíu bất định cũng gây ra lộn xộn cực kỳ. Chúng có mối quan hệ dạng lồi rất mạnh theo sự nhiễu loạn. Đây là lập luận mà tôi đã sử dụng để chứng minh rằng chúng ta không thể tính toán được các xác suất nhỏ, thậm chí nếu ta có mô hình đúng - mà lẽ dĩ nhiên là không có.
Lập luận này cũng liên quan đến việc suy ra xác suất từ tần suất quá khứ mà không sử dụng thông số. Nếu xác suất tiến tới 1/quy mô mẫu, sai số sẽ tăng vọt.
Lẽ dĩ nhiên điều này giải thích sai lầm Fukushima. Cũng như Fannie Mae. Tóm lại, xác suất nhỏ tăng mạnh (tăng gia tốc) khi ta thay đổi thông số đầu vào của phép tính.
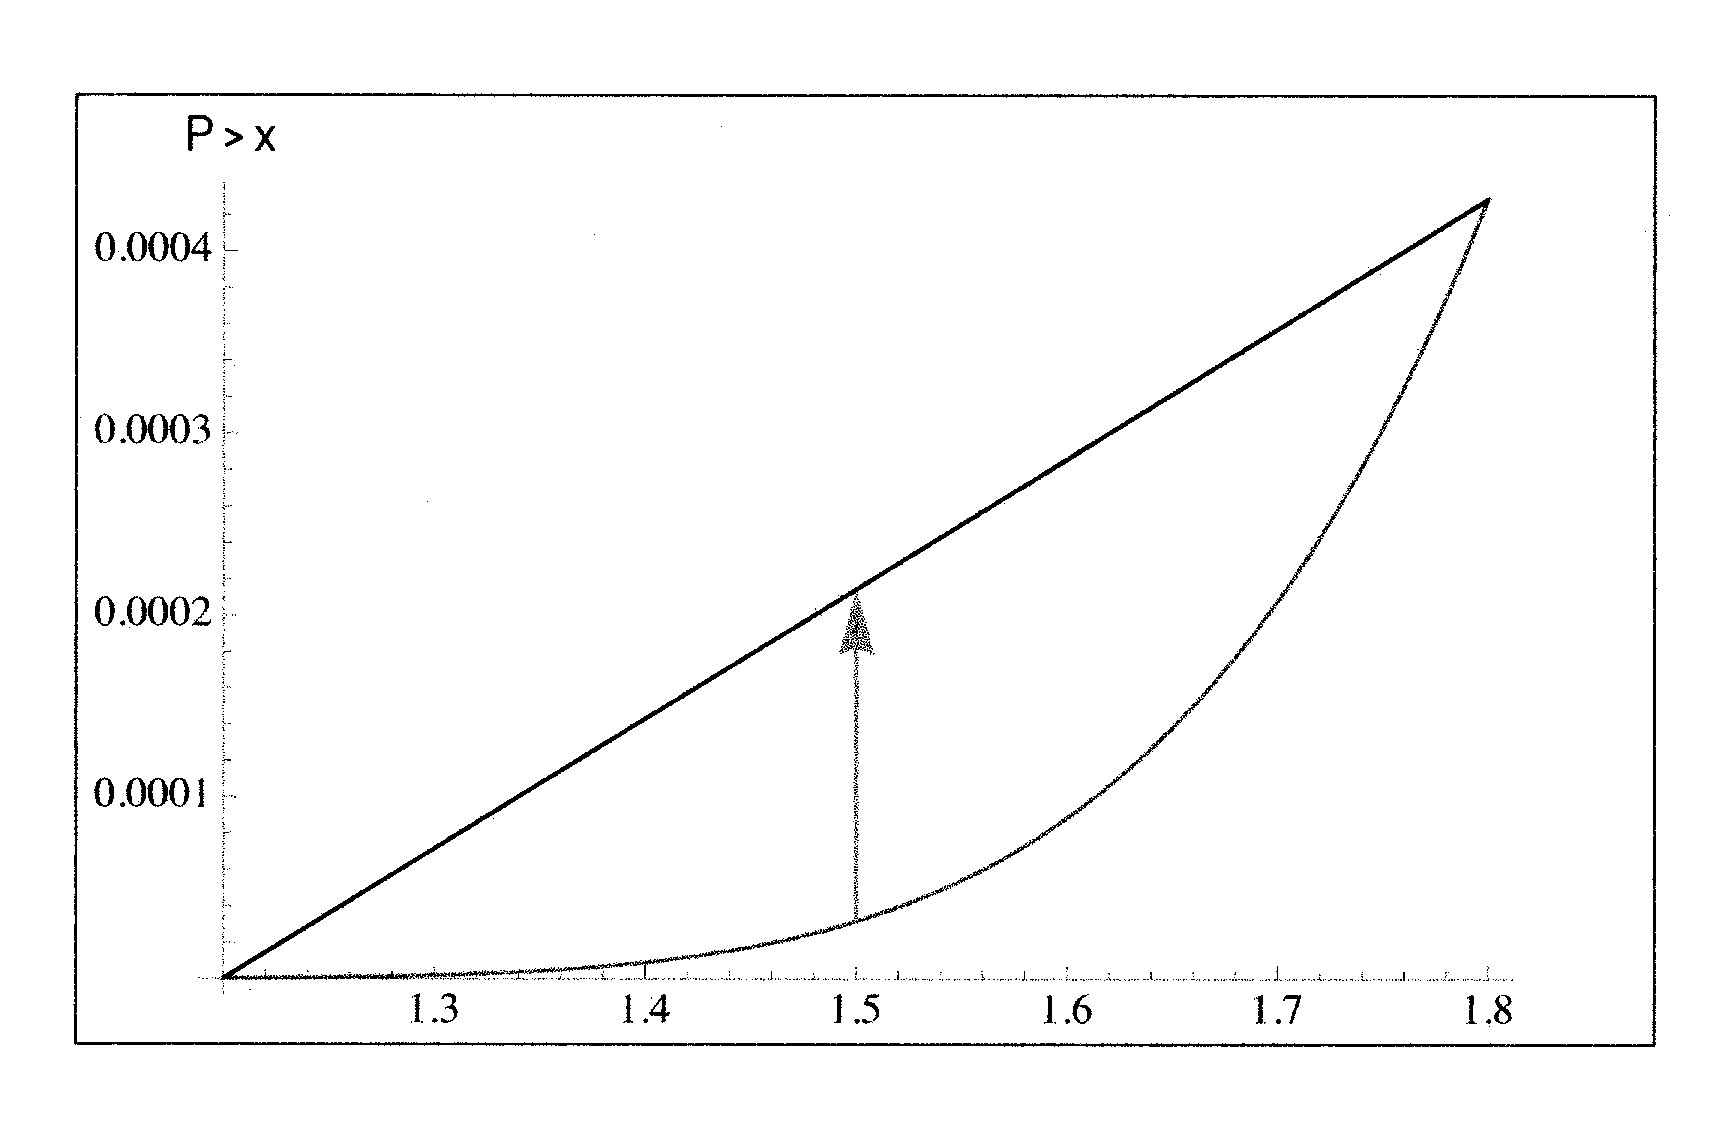
HÌNH 38. Trong mô hình Gaussian, mối quan hệ giữa xác suất và độ lệch chuẩn có dạng lồi. Đường biểu diễn cho thấy ảnh hưởng của độ lệch chuẩn đối với P>x, và so sánh giữa một bên là P>6 với độ lệch chuẩn 1,5 và một bên là P>6 giả định sự kết hợp tuyến tính giữa 1,2 và 1,8 (ở đây a(1) = 1/5).
Sự thật đáng phiền là, nhiễu loạn của ơ áp dụng cho đuôi của hàm phân phối theo một mối quan hệ có dạng lồi; rủi ro của một danh mục nhạy cảm với các biến cố đuôi sẽ tăng vọt. Nghĩa là, ta vẫn ở đang ở trong thế giới của phân phối chuẩn Gaussian! Bất trắc bùng nổ không phải là kết quả của đuôi béo tự nhiên trong hàm phân phối, mà chỉ đơn thuần là sự không chính xác nhỏ về một thông số tương lai. Nó chỉ thuộc về tri thức! Vì thế những người sử dụng các mô hình này đồng thời thú nhận tính bất định của các thông số thì nhất thiết cũng phải thú nhận về tính phi nhất quán nghiêm trọng.159
Lẽ dĩ nhiên, tính bất định lại càng tăng vọt hơn khi ta thiết lập điều kiện của thế giới thực tế vốn không phải là thế giới phân phối chuẩn Gaussian dựa vào việc làm nhiễu các cấu phần đuôi. Ngay cả với hàm phân phối theo quy tắc lũy thừa, kết quả là nghiêm trọng, nhất là trong biến thiên cấu phần đuôi, vì chúng gây ra hệ quả to lón. Thật ra, đuôi béo có nghĩa là ta không thể tính toán được các biến cố đuôi; chẳng có gì khác.
Bất định chồng chất (Fukushima)
Sử dụng phát biểu trên đây rằng việc ước lượng ngụ ý có sai số, ta hãy mở rộng logic: trong sai số có sai số; sai số đó có sai số. Việc tính đến hiệu ứng này sẽ làm cho mọi xác suất nhỏ đều gia tăng bất kể ta sử dụng mô hình gì - thậm chí trong mô hình Gaussian - cho đến lúc ta sẽ có hàm phân phối đuôi béo và hiệu ứng quy tắc lũy thừa (kể cả cái gọi là phương sai vô hạn) khi các bậc cao hơn của tính bất định là lớn. Thậm chí với mô hình Gaussian với độ lệch chuẩn ơ cũng có sai số tỷ lệ a(1); a(1) có tỷ lệ sai số a(2), vv… Bây giờ, nó phụ thuộc vào tỷ lệ sai số bậc cao hơn a(n) liên quan đến a(n - 1); nếu các sai số này theo tỷ lệ không đổi, thì ta hội tụ về một phân bố có đuôi rất béo. Nếu các sai số có tỷ lệ giảm dần, ta vẫn có những chiếc đuôi béo. Trong mọi trường họp, chỉ cần có sai số thì có chuyện không hay cho xác suất nhỏ.
Phần đáng buồn là, ta gần như không thể nào thuyết phục mọi người chấp nhận rằng mọi số đo đều có sai số - biến cố ở Fukishima chỉ xảy ra một lần trong hàng triệu năm sẽ biến thành một lần trong 30 năm nếu ta đi qua nhiều lớp bất định khác nhau một cách đầy đủ.